附录 A:高级提示技巧
提示简介
提示是与语言模型打交道的主要方式:通过设计输入,引导模型产出你想要的结果。它涵盖如何组织请求、补充语境、规定输出格式,以及用示例示范期望的回答形态。提示写得好,模型更容易给出准确、相关且有创意的回复;写得含糊,则往往得到模棱两可、文不对题或明显错误的输出。
提示工程的目标,是让模型在一次次调用中持续给出高质量回答。这要求你理解模型能做什么、做不到什么,并把目标说清楚;也意味着要学会怎样向 AI 下指令,把与模型协作练成一种可迁移的能力。
本附录在基础对话之上,展开一系列提示技巧:如何拆解复杂请求、强化推理、约束输出形态、接入外部知识等。它们既适用于轻量聊天机器人,也适用于复杂多智能体系统,并能整体抬高智能体应用的稳定性与可用性。
智能体模式——即搭建智能系统的结构方式——在正文中有系统阐述:它们规定智能体如何规划、调用工具、维护记忆与彼此协作。整套系统是否好用,很大程度上取决于智能体与语言模型之间能否形成清晰、可重复的交互。
核心提示原则
面向语言模型做有效提示时,应把握以下核心原则:
有效提示背后,是一套与语言模型沟通的通用原则,并不会因模型迭代或任务复杂化而失效。真正掌握这些原则,才更容易稳定获得有用且准确的回答。
清晰与具体: 指令要写得没有歧义、边界清楚。模型靠模式补全语义,一句话多种读法就会走向意外结果。请写清任务是什么、希望以什么格式交付、有哪些硬性约束;少用“看着办”式措辞,也少埋隐含前提。提示不到位,输出往往含糊或偏离,难以真正可用。
简洁: 具体并不意味着冗长。在信息充分的前提下,应尽量直接表达核心要求:迂回冗长的句子既消耗 token,也容易使模型偏离重点。可以记住一条经验法则:连人都觉得难懂的句子,模型通常也难以准确把握。应多用主动动词明确任务,少用装饰性从句。常见且有效的动词包括:Act、Analyze、Categorize、Classify、Contrast、Compare、Create、Describe、Define、Evaluate、Extract、Find、Generate、Identify、List、Measure、Organize、Parse、Pick、Predict、Provide、Rank、Recommend、Return、Retrieve、Rewrite、Select、Show、Sort、Summarize、Translate、Write。
善用动词: 动词是提示中最有效的控制杠杆之一,直接决定模型需要执行的操作类型。与其写“想想如何总结下面这段内容”,不如明确写成“总结以下文本”。动词越精确,越能激活与任务相匹配的知识与推理模式。
指令优于约束: 多写“请产出什么”,少写一长串“不许怎样”。在安全、合规或版式极严的场景里,否定式约束仍然必要;但若通篇都是禁令,模型容易把注意力耗在躲坑上,反而忘了正事。把力气花在正面引导上,既贴近人类协作习惯,也降低误读空间。
实验与迭代: 好提示很少一次写成。更稳妥的路径是:先打一版草稿 → 跑真实用例 → 对照目标找差距 → 再改措辞或结构。换模型、调 temperature / top-p、微调一句话,结果都可能明显不同。把每次版本与效果记下来,复盘成本会低很多;想稳定达到预期,迭代几乎是必修课。
以上原则是与语言模型协作的底层语法:先把事情说清楚、写短写准、用对动词、多用正面指引,并愿意反复试。做到这几条,再谈更复杂的提示模式,会轻松得多。
基础提示技术
在原则之上,基础技术解决的是“给模型多少示范”:零示例、一条示例,或几条示例。它们几乎是所有提示工作的起点,也能覆盖大量日常应用场景。
零样本提示(Zero-Shot)
零样本提示最朴素:只描述任务、贴上输入,不给任何“示范答案”。模型完全靠预训练里见过的模式来猜你要什么;提示本身通常就是“任务说明 + 待处理文本”。
- 何时使用: 若任务形态在预训练语料里很常见——简单问答、续写、对直白短文做摘要等——零样本往往就够用;也是排查问题时最值得先试的一条捷径。
- 示例: 将下列英文句子译成法语:'Hello, how are you?'
单样本提示(One-Shot)
单样本提示会先在正文任务前放一组“输入 → 期望输出”,相当于递给模型一张格式样张;后面的真实请求,就按同一套路来仿写。
何时使用: 一旦目标格式、语气或体裁不太“标准”,单样本通常比光说不练更有效;有一个看得见的实例,模型更容易对齐结构与口吻。
示例: 将下列英文句子译成西班牙语: 英文:'Thank you.' 西班牙文:'Gracias.'
英文:'Please.' 西班牙文:
少样本提示(Few-Shot)
少样本提示是在单样本基础上再提供若干组(通常为三到五组)输入—输出示例,使期望模式更为清晰;面对新输入时,模型按该模式生成正确结果的概率通常也会随之提高。
何时使用: 需要严格版式、固定栏目、细粒度风格差异,或做分类 / 结构化抽取时,少样本往往是标配;若零样本、单样本抖动大,更应加码示例。经验上三到五对是常见起点,再按任务难度和上下文长度微调。
示例质量与多样性的重要性: 少样本提示的效果高度依赖示例本身。示例应准确、贴近真实业务,并尽量覆盖可能出现的变体与边界情况。哪怕是很小的错误,也可能被模型误学为规律;示例越多样,面对未见过的新输入时表现通常越稳健。
分类任务中打乱类别顺序: 做分类时,别把同类示例全堆在一起;打乱顺序可以减轻模型对“排列套路”的投机,逼它去学每一类的判别特征,泛化通常更稳。
向“多样本”演进: 长上下文模型(如 Gemini 系列)使在同一提示中放入大量示例成为可能;对于复杂任务,有时确实需要几十甚至上百条示例,才能让模型掌握更细粒度的模式。
示例: 将下列影评的情感分类为 POSITIVE、NEUTRAL 或 NEGATIVE:
影评:“演技精湛,故事引人入胜。” 情感:POSITIVE
影评:“还可以,没什么特别的。” 情感:NEUTRAL
影评:“我觉得情节令人费解,角色也不讨喜。” 情感:NEGATIVE
影评:“画面令人惊叹,但对白很薄弱。” 情感:
清楚何时使用零样本、单样本或少样本提示,并认真打磨示例的顺序与内容,是提升智能体表现成本较低却效果显著的方法;许多更复杂的提示模式,本质上也建立在这层基本功之上。
组织提示的结构
光有示例还不够:提示怎么排版、怎么分块,往往决定模型读不读得懂。结构化就是把指令、背景、样例、待处理输入拆成彼此分明的段落或标签,让模型一眼知道每一段扮演什么角色。
系统提示(System Prompting)
系统提示负责给整段对话定调:说明模型扮演谁、遵守哪些红线、默认语气与深度如何。它不像单条用户提问那样转瞬即逝,而是持续约束后续所有回复;也常承担安全与文明用语等底线规则。
系统提示同样可以“机器调参”:用 LLM 反复改写、再用你定义的指标打分,自动逼近更优版本。Google Cloud 上的 Vertex AI Prompt Optimizer 就是面向这类闭环的工具之一。
- 示例: 你是一位乐于助人且无害的 AI 助手。请以礼貌且信息充分的方式回答所有问题。不要生成有害、有偏见或不适当的内容。
角色提示(Role Prompting)
角色提示让模型“戴上某副眼镜”——指定职业身份、口吻或知识边界,常与系统提示、动态语境一起出现。一句“你是资深导游”“你是偏保守的风险分析师”,就会显著改变推理角度与措辞;也可叠加“要幽默但要专业”这类风格细项。
- 示例: 扮演一位经验丰富的旅行博主。围绕罗马最值得一去的隐秘宝地,写一段简短而吸引人的文字。
使用分隔符
当提示里同时出现规则、背景、例题和真实输入时,务必让它们“物理上”也分得开:三反引号代码块、XML 风格标签(如 <instruction> / <context>)、或 --- 一类的显式分隔线都可以。目的只有一个——降低串台,让模型别把你的数据当成新指令。
- 示例:
[在此处插入文章全文]
上下文工程(Context Engineering)
如果说系统提示定义的是长期角色设定,那么上下文工程关注的就是“模型在当前时刻应当掌握哪些信息”。它把历史轮次、检索到的文档(RAG)、工具返回结果以及业务参数等动态注入上下文窗口,使回答建立在事实与当前上下文之上,而非凭空续写。对智能体而言,上下文工程直接关系到记忆是否连贯、规划是否可靠、多步任务能否保持一致;一条设计良好的上下文管线,往往比单纯更换更大模型更能显著提升效果。这也标志着提示工作正从“打磨一句话”走向“构建多层信息栈”。
常见的上下文分层包括:
- 系统提示: 规定模型“默认工作方式”的底层指令(例:“你是技术文档作者,语气必须正式、可核查”)。
- 外部数据:
- 检索文档: 从向量库、Wiki、工单系统等拉回的事实片段,用来压住幻觉。
- 工具输出: 计算器、日历、CRM、天气 API 等实时回包,让回答跟现实世界同步。
- 隐式数据: 用户画像、权限、历史行为、设备状态等未明说却影响决策的信息。引入这类信号必须同步考虑隐私、同意与留存策略——在金融、医疗、政务场景尤其要有治理台账。
一句话概括:再强的模型,如果当前可见信息残缺或噪声过大,表现也会明显受限。上下文工程要做的,是把问题从“模型会不会回答”推进到“模型是否掌握了完成任务所需的完整现场信息”。例如,若在回复邮件前同时具备日历空档(工具输出)、与收件人的项目关系(隐式信息)以及上一轮会议纪要(检索文档),那么输出才更可能既得体又可执行。其工程化部分则包括可靠的数据抓取、清洗、裁剪,以及通过评测结果反哺下一轮上下文设计。
落地时,可以借助 Vertex AI Prompt Optimizer 这类平台,把“试提示”工业化:批量喂入样本输入,用你定义的指标自动打分,再迭代改写系统指令或提示模板,减少人肉 A/B。 这背后是一种产品哲学的分野——把上下文当成与模型平起平坐的一等公民,明确“何时注入何种信号、如何验证它仍然新鲜”。当意图、历史与环境状态被结构化地呈现给模型,聊天机器人才能从“会接话”进化成“懂现场”的智能体。
结构化输出
在很多场景中,你需要的并非一段自由文本,而是可供下游程序直接处理的数据。若在提示中明确指定 JSON、XML、CSV、Markdown 表格等格式,并附上字段说明或样例,模型通常更容易按要求组织输出。对抽取、标注、填表等任务而言,JSON 尤其值得优先考虑,因为字段一旦固定,模型自由发挥的空间就会明显缩小。对于非创意类流程,也建议对不同输出载体进行比较,选择最稳定的方案。
示例: 从下方文本中提取信息,并以 JSON 对象返回,键名为
name、address和phone.number。文本:“请通过加利福尼亚州 Anytown 市 Main St 123 号联系 John Smith,或致电 (555) 123-4567。”
把系统提示、角色设定、动态上下文、分隔符和结构化输出组合使用,交互就能从普通对话升级为可编排流程;其中结构化输出几乎是所有自动化流水线的硬性前提,缺少它,后续脚本便难以稳定接续。
用 Pydantic 做类型门面: 让 LLM 生成 JSON 只是第一步,更稳妥的做法是将结果解析进 Pydantic 模型。Pydantic 使用 Python 类型注解描述字段含义与约束,并在解析时自动完成校验与类型转换,相当于在提示与业务逻辑之间增加了一层强类型校验。
可直接调用 model.validate.json,将 LLM 返回的 JSON 一次性解析并校验为对象,从而减少手动 json.loads 与额外条件判断的样板代码。
from pydantic import BaseModel, EmailStr, Field, ValidationError
from typing import List, Optional
from datetime import date

# --- Pydantic Model Definition (from above) ---
class User(BaseModel):
    name: str = Field(..., description="The full name of the user.")
    email: EmailStr = Field(..., description="The user's email address.")
    date_of_birth: Optional[date] = Field(None, description="The user's date of birth.")
    interests: List[str] = Field(default_factory=list, description="A list of the user's interests.")

# --- Hypothetical LLM Output ---
llm_output_json = """
{
    "name": "Alice Wonderland",
    "email": "[email protected]",
    "date_of_birth": "1995-07-21",
    "interests": [
        "Natural Language Processing",
        "Python Programming",
        "Gardening"
    ]
}
"""

# --- Parsing and Validation ---
try:
    # Use the model_validate_json class method to parse the JSON string.
    # This single step parses the JSON and validates the data against the User model.
    user_object = User.model_validate_json(llm_output_json)

    # Now you can work with a clean, type-safe Python object.
    print("Successfully created User object!")
    print(f"Name: {user_object.name}")
    print(f"Email: {user_object.email}")
    print(f"Date of Birth: {user_object.date_of_birth}")
    print(f"First Interest: {user_object.interests[0]}")

    # You can access the data like any other Python object attribute.
    # Pydantic has already converted the 'date_of_birth' string to a datetime.date object.
    print(f"Type of date_of_birth: {type(user_object.date_of_birth)}")
except ValidationError as e:
    # If the JSON is malformed or the data doesn't match the model's types,
    # Pydantic will raise a ValidationError.
    print("Failed to validate JSON from LLM.")
print(e)这段示例展示完整闭环:先用 Pydantic 描述 User 结构,再将假想的 LLM JSON 传给 model.validate.json 做解析与校验;成功时可得到可通过属性访问的 Python 对象,若 JSON 损坏或字段不匹配,则进入 ValidationError 分支并打印原因。
若上游是 XML,可先用 xmltodict 之类工具展平成字典,再映射到 Pydantic;借助 Field(alias=...) 能把层级很深或属性很多的标签,折叠成干净的 Python 属性名。
一旦 LLM 输出被封装为经过校验的对象,后续函数、微服务或队列消费者就能按照明确契约处理数据,而不必在字符串中猜测字段含义。在系统边界上坚持“先解析,再进入业务逻辑”(parse, don't validate),通常能显著缩小故障面,并提升排障效率。
再强调一次:系统提示、角色设定、上下文、分隔符与结构化输出是一套需要协同运作的方法体系;其中结构化输出是将模型稳定嵌入自动化系统的关键环节,缺少这一点,后续步骤往往只能依赖人工兜底。
(对应前文“Structuring Prompts”段)除了堆示例,提示本身的章节划分同样决定模型读不读得懂:用标签或空行把指令、背景、样例、用户输入隔开,让模型知道哪里是规则、哪里是素材。
推理与思维过程技术
大模型读模式、写文字都很强,一旦涉及多步推演就容易跳步或算错。本附录介绍的一系列方法,核心都是让模型把中间推理摊开给人看,从而稳住逻辑、算术与规划类任务。
思维链(Chain of Thought, CoT)
思维链(CoT)的做法很直白:别只要答案,让模型先把推理过程写出来,再收尾。常用触发语是“Let's think step by step”,效果类似人类把难题拆成一串可检查的小步骤。
对需要算数、推导或严谨逻辑的任务,CoT 往往显著降错:模型被迫把中间态写出来,就不那么容易一口蒙错。链条本身也便于你事后核对哪一步开始偏航。
CoT 常见两条路线:
- 零样本 CoT: 只追加一句 “Let's think step by step”(或同义改写),不给例题;对不少任务,这一行字就能撬动模型把推理轨迹外化。
- 示例(零样本 CoT): 如果一列火车以每小时 60 英里的速度行驶,共行驶 240 英里,那么这趟旅程耗时多久?让我们一步步思考。
- 少样本 CoT: 把“例题里的推理过程也写全”,让模型照抄叙事节奏;步骤复杂时,往往比零样本 CoT 更稳。
示例(少样本 CoT): 问:三个连续整数的和是 36。这三个整数分别是多少? 答:设第一个整数为 x。下一个连续整数是 x+1,第三个是 x+2。它们的和为 x + (x+1) + (x+2) = 3x + 3。已知总和是 36,所以 3x + 3 = 36。等式两边同时减去 3,得到 3x = 33。再除以 3,得到 x = 11。因此,这三个整数是 11、11+1=12 和 11+2=13,即 11、12、13。
问:Sarah 有 5 个苹果,又买了 8 个,随后吃掉 3 个。她还剩多少个苹果?让我们一步步思考。 答:让我们一步步思考。Sarah 一开始有 5 个苹果。她又买了 8 个,所以在原有数量上加 8:5 + 8 = 13 个苹果。随后她吃掉 3 个,因此从总数中减去 3:13 - 3 = 10。Sarah 还剩 10 个苹果。答案是 10。
CoT 的甜头在于上手快——不用训模型也能涨分;链条展开后,解释性与可调试性都更好,换模型版本时提示也通常更抗漂移。代价同样直观:输出变长,token、时延、账单一起涨。
实操上记得两点:一是先把推理写透,再落最终答案——前面的 token 会一路约束后面的走向;二是遇到唯一正确答案(典型数学题),把 temperature 拉到 0 做贪心解码,让每一步都走概率最高的续写,减少随机胡闹。
自洽性(Self-Consistency)
自洽性(Self-Consistency)把 CoT 从“单路径”升级成“多路径投票”:同一提示多跑几次、拉高温度换思路,最后对答案做多数决,用统计对抗单次抽风的概率。
典型流程分三步:
- 生成多样推理路径: 复用同一条(通常已含 CoT 的)提示,多次采样;温度略高,鼓励走出不同论证故事。
- 抽取答案: 从每条轨迹里抠出最终结论。
- 选取最常见答案: 对结论做投票,得票最高者当选——相当于用 ensemble 换稳健。
它适合“可行思路不止一条”或“单次采样容易失误”的场景;同时还能提供一种近似置信度,票数分布可作为判断答案可靠性的参考。其缺点也很明显:同一问题需要运行 N 次,算力消耗与成本会线性增加。
- 示例(概念性):
- 提示:“‘所有鸟都会飞’这个说法是真是假?请解释你的推理过程。”
- *模型第 1 次运行(高温):*围绕大多数鸟都会飞展开推理,结论为“真”。
- *模型第 2 次运行(高温):*围绕企鹅和鸵鸟展开推理,结论为“假”。
- 模型第 3 次运行(高温):围绕一般意义上的鸟类展开推理,简要提及例外,结论为“真”。
- *自洽性结果:*根据多数投票(“真”出现两次),最终答案为“真”。(注:更复杂的方法还会权衡推理质量。)
退一步提示(Step-Back Prompting)
退一步提示的核心在于“先抽象、后具体”:先询问与任务相关的一般原则或框架,再将这份高层回答嵌入真正要解决的问题中,作为后续推理的脚手架。
这样先把相关“课本知识”唤醒,再落笔细节,通常能减少被题干表面词带偏的情况;对写作、方案类任务,也能先立住结构再填肉。强调通则还有助于弱化一些刻板印象式的捷径回答——当然仍要配合安全审核。
- 示例:
- 提示 1(退一步):“哪些关键因素能成就一篇优秀的侦探小说?”
- 模型回答 1:(列出红鲱鱼式误导线索、有说服力的动机、有缺陷的主人公、合乎逻辑的线索、令人满意的结局等要素。)
- 提示 2(原始任务 + 退一步上下文):“运用优秀侦探小说的关键因素[在此处插入模型回答 1],为一部以小镇为背景的新悬疑小说写一份简短的情节梗概。”
思维树(Tree of Thoughts, ToT)
思维树(ToT)把 CoT 的直线叙事改成可分支搜索:每个节点是一段完整中间思考,从节点可以继续长出不同假设,像人在脑内试几条路线再择优。
它适合需要试错、回溯或显式比较多条路径的复杂问题;虽然算力成本与工程复杂度都高于线性 CoT,但在策划、谜题求解、组合优化等场景中往往回报可观。对智能体而言,它提供了在某条推理路径失效时切换分支的能力,而不必沿单一路径持续推进。
- 示例(概念性): 像“给定情节点,写三种收束方式”这类任务,ToT 会在关键情节点同时展开多条故事枝,而不是一口气顺写到底。
这些技巧让智能体不止会“查资料 + 润色”,而是能承担真正的多步认知劳动:把推理摊开、多角度自检、必要时回到抽象层重新框定问题。
行动与交互技术
智能体不止“会说话”,还要能动手:查 API、跑函数、读传感器,并在观察 → 思考 → 行动之间循环。本节聚焦如何把这类行为写进提示里,让模型知道何时出手、如何出手。
工具使用(函数调用)
工具调用把模型从“纯文本生成”推进到“可执行工作流”:搜索、查库、发信、执行计算、发起 HTTP 请求等。提示中应写清触发条件、参数格式与失败时的回退策略,否则模型要么滥用工具,要么不敢调用。
新一代模型普遍经过工具调用对齐训练:读得懂 JSON Schema 式的工具说明书,也能在对话中决定“要不要用、用哪一个、传什么参”。真正执行动作的仍是宿主程序——模型只负责生成结构化的调用意图;运行环境执行后,再将 Observation 回传给模型,对话才能闭环。
示例: 你可以使用一个天气工具,查询指定城市的当前天气。该工具名为 '
get.current.weather',接收一个 'city' 参数(字符串)。用户:伦敦现在的天气怎么样?
- 预期模型输出(函数调用): { "tool.code": "get.current.weather", "tool.name": "get.current.weather", "parameters": { "city": "London" } }
ReAct(推理与行动)
ReAct 将“显式思维链式 CoT”与“调用工具获取新信息”编织在同一条轨迹中:模型先 Thought,再 Action,环境返回 Observation,循环直至给出 Final Answer——这一流程非常接近人类边思考边查证资料的习惯。
标准循环长这样:
- Thought: 用自然语言交代现状、缺口与下一步打算。
- Action: 点名要调的工具及参数(Search、Calculator、HTTP 等)。
- Observation: 运行时真正执行工具,将原始结果回写到对话中。
- 如此往复,直到模型判断信息足够,再输出 Final Answer 收束。
这种交错结构让智能体可以随着新事实不断修正计划,特别适合信息实时变化或必须查外部世界的任务。
示例(说明性 ReAct 轨迹): 用户:法国的首都是哪里?目前人口有多少?
思考:用户询问两项信息:法国的首都和人口。我可以使用搜索工具查找这些信息。我会先确认首都,尽管我很可能已经知道答案。 行动:Search({"query": "capital of France"}) 观察:Paris
思考:好的,首都是 Paris。现在我需要查找 Paris 的人口。 行动:Search({"query": "current population of Paris"}) 观察:据估计,2023 年 Paris 的人口约为 210 万。
思考:我已经找到这两项信息,现在可以向用户给出最终答案。 最终答案:法国的首都是 Paris,据估计,2023 年其人口约为 210 万。
没有工具调用与 ReAct 式循环,智能体只能停留在“语言模拟”;有了它们,系统才真正接得上外部世界。
进阶技术
在这些基础方法之外,还可以借助 AI 辅助生成提示、用检索补充知识,或根据受众画像调整语气风格;这些补充技巧往往决定系统能否从演示原型走向生产落地。
自动提示工程(APE)
提示设计往往需要反复试验,而 APE 的思路是让另一个(或同一个)LLM 充当提示优化器:批量生成候选提示、自动评分并择优迭代,从而减少人工反复试错的负担。
典型流水线:先描述任务 → 元模型生成 N 版提示 → 在固定评测集上跑分(自动指标或人工)→ 保留冠军并可继续变异。训练聊天机器人时让 LLM 改写用户问法,也属于同一思想。
- 示例(概念性): 需求描述可能是“帮我写个提示,稳定抽出邮件日期和发件人”。APE 批量生成若干版本,在真实邮件样本上跑一遍,留下表现最稳的那条。
紧接着补一段关于 DSPy 式“程序化提示优化”的说明(在原文基础上略作展开):
DSPy 代表的另一条路,是把提示当成代码里的可学习参数:不是死文本,而是随数据与损失函数一起被搜索、被重写,让优化过程可复现、可版本化。
这一方法依赖两项核心组成:
- 金标集: 一批高质量输入—输出对,告诉优化器“满分长什么样”。
- 目标函数: 自动把模型答案与金标比对,给出可优化的标量分数(准确率、F1、人工偏好均可)。
有了分数,就能交给贝叶斯优化、遗传算法或简单网格搜索去改提示。常见两条支线可以单飞也可以混用:
- 少样本示例优化: 不再靠肉眼挑例题,而是让程序在金标集里组合、重排、抽样不同示例子集,看哪一组最能拉高平均分。
- 指令文本优化: 让元模型像改稿编辑一样反复 mutate 系统提示——换词、换语气、换段落顺序——直到评分函数满意为止。
无论走哪条路,本质都是在最大化同一个目标函数——把提示当成可学习对象去“拟合金标”。两条线一起开,等于同时搜最佳措辞与最佳例题组合,往往比单修其一更狠。
迭代提示 / 精炼
与 APE 的自动化相对,这里强调“人眼盯结果”:先写个能跑的朴素提示,看答案哪里软,再针对性补约束、补示例、补语境——经典人机共演。
- 示例:
- 第 1 次尝试:“为一种新型咖啡机撰写产品描述。”(结果过于笼统。)
- 第 2 次尝试:“为一种新型咖啡机撰写产品描述。突出它制作咖啡速度快、易于清洁的特点。”(结果有所改善,但缺乏细节。)
- 第 3 次尝试:“为‘SpeedClean Coffee Pro’撰写产品描述。重点介绍它能在 2 分钟内煮好一壶咖啡,以及它的自动清洁程序。目标受众是忙碌的职场人士。”(结果已非常接近期望。)
提供反例
“多写希望得到什么”仍然是主要原则,但在特定场景下,展示错误示范也可能带来帮助:明确告诉模型“这种输出不可接受”,有助于压制某些特定失误模式。不过,反例不宜过多,否则提示又会退化为一长串否定式约束。
示例: 生成一份巴黎热门旅游景点清单。不要包含埃菲尔铁塔。
错误做法示例: 输入:列出巴黎的热门地标。 输出:埃菲尔铁塔、卢浮宫、巴黎圣母院。
使用类比
把陌生任务映射成熟悉场景(厨师、教练、侦探……),模型更容易抓住语气、步骤与输出粒度;写故事、做教学设计时尤其好使。
- 示例: 扮演一位“数据厨师”。把原始食材(数据点)烹制成一道“摘要菜肴”(报告),向商业受众突出其中的关键风味(趋势)。
因子化认知 / 分解
面对巨型任务,先切成可独立验证的小块,每块单独提示,再拼装终稿——这和提示链、规划模式是亲戚,只是更强调“分解的颗粒度要可测试”。
- 示例: 撰写研究论文时:
- 提示 1:“为一篇探讨 AI 对就业市场影响的论文生成详细大纲。”
- 提示 2:“根据这份大纲撰写引言部分:[插入大纲中的引言]。”
- 提示 3:“根据这份大纲撰写‘对白领工作的影响’一节:[插入大纲中的对应章节]。”(其他章节依此重复。)
- 提示 N:“合并这些章节并撰写结论。”
检索增强生成(RAG)
RAG 的公式很简单:问句先进检索器,拉回相关片段,再连同原文一起塞进提示。这样回答有“出处”,幻觉显著收敛,也能覆盖训练 cutoff 之后或公司内部才有的知识——是落地智能体系统的标配组件。
- 示例:
- 用户查询:“Python 库‘X’的最新版本有哪些新功能?”
- *系统操作:*在文档数据库中搜索“Python library X latest features”。
- 提供给 LLM 的提示:“根据以下文档片段:[插入检索到的文本],解释 Python 库‘X’最新版本的新功能。”
人格模式(用户人格)
角色提示回答“模型是谁”;人格模式回答“讲给谁听”。把受众年龄、背景、痛点写清楚,模型会自动调节术语密度、举例风格与信息深度。
示例: 你需要解释量子物理。目标受众是一名此前没有相关基础知识的高中生。请用简单的方式解释,并使用他们容易理解的类比。
解释量子物理:[插入基础解释请求]
这些加分项让提示工程师能在工作流里同时调模型、调数据、调受众画像,把“能跑”打磨成“好用”。
使用 Google Gems
Google 生态里的 Gems(见图 1)相当于给 Gemini 套一层可保存的“快捷人设”:用户写好自己的系统指令,就得到一个面向固定场景的专用实例,后续对话都会自动继承那份用途、语气与知识边界设定。
你可以为不同工种各存一颗 Gem:只解释公司批准过的内部 SDK、只输出数据洞察而不瞎猜因果、或严格遵循某本翻译体例。本质是让用户级上下文变成可复用资产,而不是每次从零复述。
好处是省掉每次重复的开场铺垫:开聊即专业模式,token 预算花在刀刃上,输出也更一致。它把“用户长期意图”焊进产品层,让通用大模型在体验上像一排垂直助理。
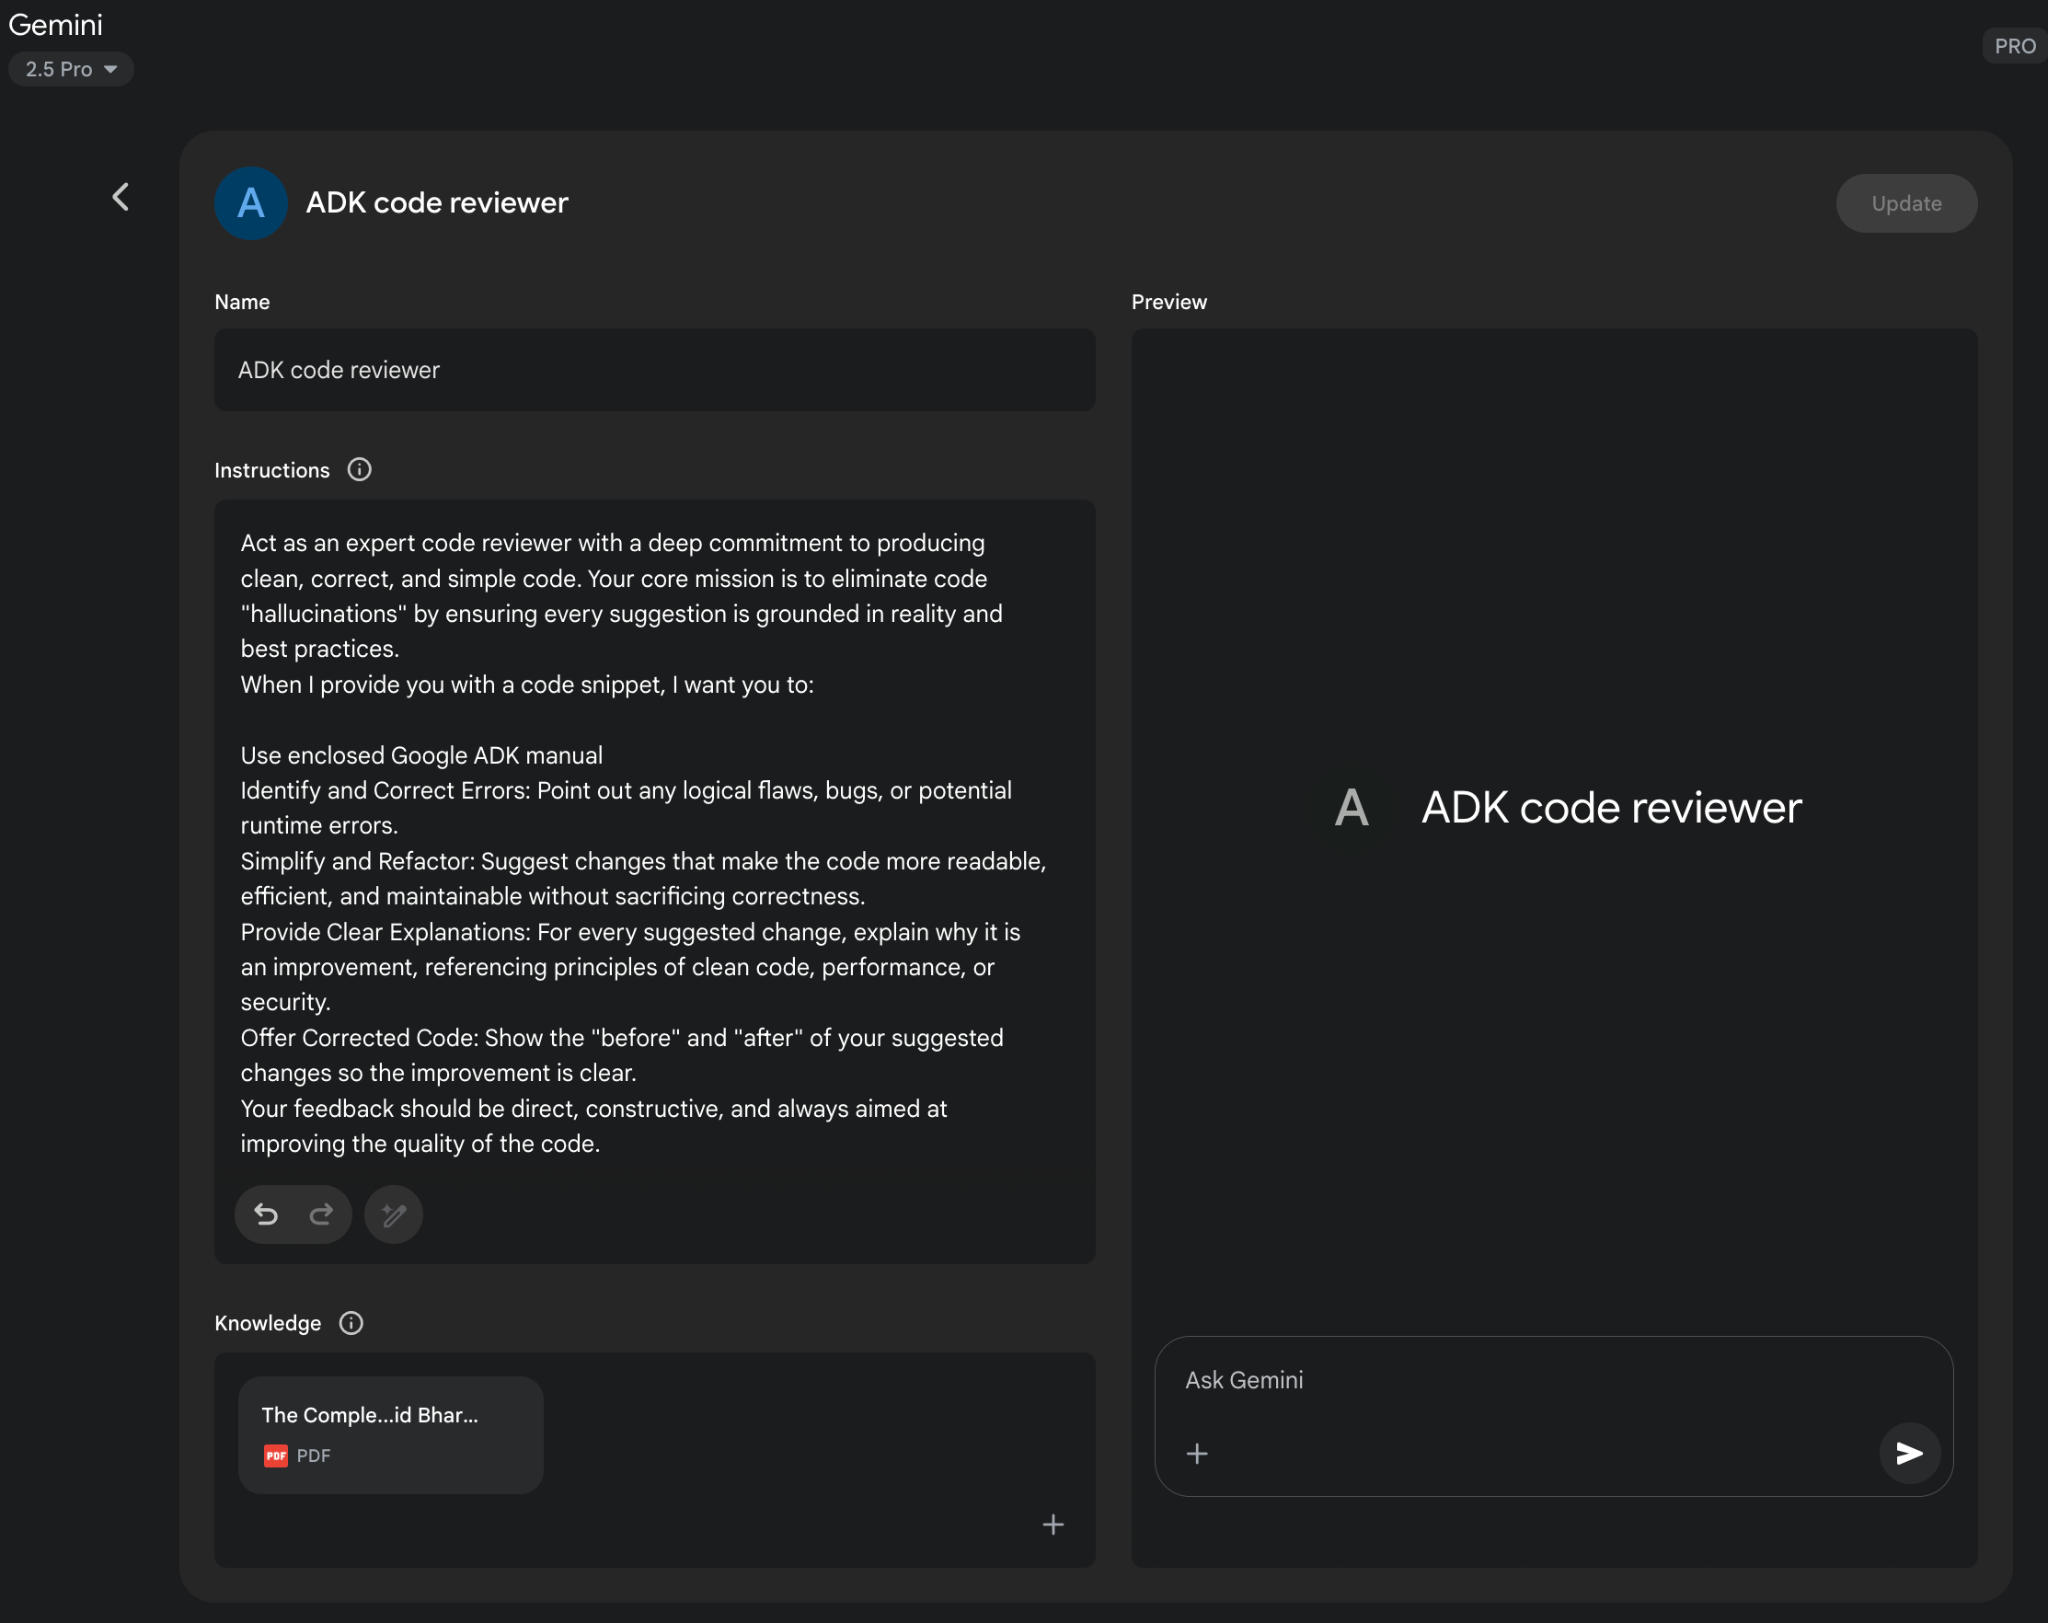
图 1:Google Gem 使用示例。
用 LLM 精炼提示(元方法)
前文介绍了大量技法,但真正落地时,最耗时的往往仍是反复改写提示。如果让 Gemini 这类模型读取旧提示、分析失败样例,再提出改写建议,会怎样?这正是提示精炼的“元用法”——用 AI 优化提供给 AI 的提示语句。
它既像“AI 教 AI”,也像给人类配了个懂套路的共笔:模型见过大量失败提示,往往能一眼指出含糊点、缺失约束或糟糕示例。
实操模板:旧提示 + 任务说明 + 好/坏输出对照 + 你认为的失败原因,然后请评审模型输出“问题清单 + 改写草案”。
强模型能具体告诉你:哪里一句话两读、哪里缺字段约定、哪里示例带毒,并主动提议加标签、加 JSON 样例、换角色或补少样本示例——基本就是把本附录目录又走了一遍。
这么做的好处很实在:
- 加速迭代: 一晚上能试三代提示,而不是三代日历日。
- 发现盲区: 自己读十遍也视而不见的歧义,模型可能第一句就点破。
- 学习机会: 把建议当案例库,慢慢形成肌肉记忆。
- 可扩展性: 有成百上千条提示时,可脚本化批量做提示评审。
当然,评审模型也会瞎改——所有建议都要回归真实用例测一遍。把它当加速器,而不是自动真理机。
用于精炼的示例提示: 分析下面这条面向语言模型的提示,并提出改进建议,使其能够稳定地从新闻文章中提取主要主题和关键实体(人物、组织、地点)。当前提示有时会漏掉实体,或误判主要主题。
现有提示: “总结这篇文章的要点,并列出其中重要的人名和地点:[插入文章文本]”
改进建议:
这个例子演示“模型 B 像做代码评审那样审模型 A 的提示”。把底层指令调顺,上层智能体自然更稳——算是套了一层自我对齐的幽默闭环。
面向特定任务的提示
上面的套路大多通用,但写代码、喂图片/音频时还有额外坑位,需要专门留心。
代码提示
接受过大量开源代码训练的模型,往往能够在 IDE 中充当高效的开发助手。面向代码的提示大体可分为四类:编写、解释、翻译与修复。
- 写代码: 用自然语言描述 I/O 与边界,换可运行片段。
- 示例:“编写一个 Python 函数,接收数字列表并返回平均值。”
- 解释代码: 贴片段,要求逐行或高层摘要。
- 示例:“解释以下 JavaScript 代码片段:[插入代码]。”
- 翻译代码: 指定源/目标语言与标准库差异。
- 示例:“将以下 Java 代码翻译为 C++:[插入代码]。”
- 调试与审阅: 附上报错栈、输入样例、期望行为,请模型定位与改写。
- 示例:“以下 Python 代码报出了‘NameError’。问题出在哪里,该如何修复?[插入代码和堆栈跟踪]。”
想让代码一次到位,记得交代运行环境、依赖版本、风格约束(类型注解、测试框架),以及“错在哪、对长什么样”。
多模态提示
虽然本附录仍以文本交互为主线,产业界已大规模部署图文音混合模型。多模态提示就是把这些不同通道的信号打包进同一条请求,让模型对齐跨模态信息。
- 示例: 上传架构图请逐步解释(图 + 文);或给产品照片生成电商标题(图 + 文 → 文)。
模态越多,提示越要像导演分镜:先告诉模型每张图/每段音频的角色,再下达合成任务。
最佳实践与实验
提示工程没有一劳永逸的终点,更像一项需要持续打磨的实践。下面这份对照清单值得长期参考:
- 提供示例: few-shot 仍然是最便宜的性能杠杆。
- 简洁设计: 能一句话说清就别用从句套娃。
- 明确输出: 字数、列表层级、语气、引用格式都写死。
- 指令优于约束: 先写主成功路径,再补少数否定项。
- 控制最大 token: 结合
max_tokens与提示内字数上限双保险。 - 使用变量: 模板化提示,别把客户名写死在 git 里。
- 试验输入形式与文风: 同一任务试试祈使句 vs 疑问句,分数可能差一截。
- 分类少样本打乱类别: 防模型背顺序。
- 适配模型更新: 新模型发布=回归测试日。
- 试验输出格式: 结构化输出往往是工程化的分水岭。
- 与他人协作实验: 交叉评审能暴露集体盲区。
- CoT 实践: 先链式推理再答案;客观题配合 temperature 0。
- 记录尝试: 若缺乏日志记录,提示调优过程便会沦为难以复盘的黑箱试错。
- 在代码库中保存提示: 和代码一起走代码评审。
- 依赖自动化测试与评估: 线上漂移最早体现在指标仪表盘。
写得越多、测得越勤、记录得越细,你就越能把模型当成可靠组件,而不是不可预测的黑箱;这也正是迈向更高阶智能体开发的真正门槛。
结语
本附录把“写提示”升格成可度量的工程:目标不是聊得开心,而是把通用大模型锻造成面向具体任务、可依赖、可复现的工具链一环。一切从三条铁律出发——说清楚、写简短、肯迭代——它们直接决定自然语言这份模糊接口能否被收紧成可执行的意图。零样本、单样本、少样本则是示范期望行为的三档油门,用示例的密度换取对风格、语气、版式的控制力。再往上,系统指令、角色、分隔符共同构成提示的“软件架构”,没有这一层,就很难做细粒度治理。
一旦进入自主智能体场景,提示质量几乎就是系统可用性的晴雨表:多步计划、子任务委派、回滚策略,全都建立在每一步输出可预测的前提上。思维链、思维树等推理模板,本质是强迫模型把黑箱思考摊在阳光下,再把大目标切碎成可验证的小票。也正因为如此,JSON Schema + Pydantic 这类“硬接口”不再是锦上添花——没有结构化契约,工具节点之间就会靠猜字符串对齐,自动化流水线随时可能因为一次格式漂移而全线崩溃。换句话说,结构与推理技术负责把概率模型从“会说话”推进到“能当齿轮”。
最后,提示还是智能体与世界握手的协议:ReAct、函数调用让模型长出可以执行副作用的“手”;RAG、动态语境则提供持续刷新的“感官”,把决策拴在最新事实上,而不是困在训练截止日之前的静态记忆里。把上述全谱方法融会贯通,才算真正完成从“聊天模型”到“能自主推进任务的系统”的跃迁。
参考文献
以下资源可用于进一步阅读和深入探索提示工程技术:
- Kaggle 白皮书:《提示工程》(Prompt Engineering),https://www.kaggle.com/whitepaper-prompt-engineering
- 《思维链提示激发大语言模型的推理能力》(Chain-of-Thought Prompting Elicits Reasoning in Large Language Models),https://arxiv.org/abs/2201.11903
- 《自洽性提升语言模型的思维链推理能力》(Self-Consistency Improves Chain of Thought Reasoning in Language Models),https://arxiv.org/pdf/2203.11171
- 《ReAct:在语言模型中协同推理与行动》(ReAct: Synergizing Reasoning and Acting in Language Models),https://arxiv.org/abs/2210.03629
- 《思维树:利用大语言模型进行深思熟虑的问题求解》(Tree of Thoughts: Deliberate Problem Solving with Large Language Models),https://arxiv.org/pdf/2305.10601
- 《退一步思考:通过抽象激发大语言模型的推理能力》(Take a Step Back: Evoking Reasoning via Abstraction in Large Language Models),https://arxiv.org/abs/2310.06117
- 《DSPy:以编程而非提示的方式使用基础模型》(DSPy: Programming—not prompting—Foundation Models),https://github.com/stanfordnlp/dspy