第 1 章:提示链
提示链模式概览
提示链,也常被称为流水线(Pipeline)模式,是使用大语言模型(LLM)处理复杂任务时的一种强大范式。与其期待 LLM 在单一、笼统的一步中解决复杂问题,不如采用分而治之的策略:把原本棘手的大问题拆解为一系列更小、更易处理的子问题;每个子问题都由专门设计的提示分别处理,而前一步生成的结果会作为下一步的输入。
这种顺序处理方式在与 LLM 的交互中天然带来模块化与清晰度。分解复杂任务后,每一步都更易理解与调试,整体流程也更稳健、可解释。链中每一步都可精心设计与优化,以聚焦更大问题中的某一侧面,从而得到更准确、更聚焦的输出。
一步的输出作为下一步的输入至关重要。这种信息传递形成依赖链,因而得名「链」:先前步骤的上下文与结果会引导后续处理,使 LLM 能在已有产出上继续建构、细化理解,并逐步逼近目标答案。
此外,提示链不仅用于拆解问题,也能整合外部知识与工具。在每一步中,都可以引导 LLM 与外部系统、API 或数据库交互,从而突破训练数据的限制。这大幅拓展了 LLM 的能力边界,使其不再只是孤立运行的模型,而能成为更大、更智能系统中的关键组成部分。
提示链的意义不止于解题,它也是构建复杂智能体(agent)的基础手段。这些智能体可以借助提示链,在动态环境中自主规划、推理和行动。通过有策略地组织提示顺序,智能体能够处理需要多步推理、规划与决策的任务;这类工作流也更接近人类的思维过程,因此能更自然、更有效地与复杂领域和系统互动。
单条提示的局限: 面对多维度任务,把一条复杂提示直接交给 LLM 往往效率不高。模型容易在多重约束与指令之间顾此失彼,并可能出现:指令忽视(遗漏提示中的部分要求)、上下文漂移(偏离最初语境)、错误传播(前期错误被后续步骤放大)、在需要更长上下文时因信息不足而难以作答,以及幻觉(认知负荷升高,生成错误信息的概率上升)。例如,一条请求若同时要求分析市场调研报告、总结发现、提炼带数据支撑的趋势并起草邮件,就很容易失效。模型可能摘要做得不错,却无法准确提取数据,或无法妥善完成邮件撰写。
靠顺序分解提升可靠性: 提示链把复杂任务拆成聚焦的、按序推进的工作流,从而显著提升可靠性与可控性。就上文例子而言,流水线或链式做法可描述如下:
- 初始提示(总结):「请总结以下市场调研报告的关键发现:[正文]。」模型只专注总结,提高第一步的准确度。
- 第二条提示(趋势识别):「基于上述总结,识别三大新兴趋势,并提取支持每条趋势的具体数据点:[第 1 步输出]。」该提示约束更紧,且直接建立在已验证的输出之上。
- 第三条提示(邮件撰写):「请起草一封简洁邮件给营销团队,列出下列趋势及其支撑数据:[第 2 步输出]。」
这种分解方式有助于对流程进行更细粒度的控制。每一步都更简单、歧义更少,从而减轻模型的认知负荷,使最终输出更准确、更可靠。这种模块化思路类似计算流水线:每个环节完成特定操作后,再把结果传递给下一环节。为确保各子任务得到高质量响应,还可以在每一阶段为模型赋予不同角色。例如在上述场景中,第一步可设为“市场分析师”,第二步设为“行业分析师”,第三步设为“专业文档写作者”,以此类推。
结构化输出的作用: 提示链的可靠性高度依赖步骤间传递数据的完整性。若某步输出含糊或格式混乱,下一步可能因输入不当而失败。为缓解这一点,指定 JSON、XML 等结构化输出格式至关重要。
例如,趋势识别步骤的输出可格式化为 JSON 对象:
{  "trends": [
        {
            "trend_name": "AI-Powered Personalization",
            "supporting_data": "73% of consumers prefer to do business with brands that use personal information to make their shopping experiences more relevant."
        },
        {
            "trend_name": "Sustainable and Ethical Brands",
            "supporting_data": "Sales of products with ESG-related claims grew 28% over the last five years, compared to 20% for products without."
        }
    ]
}这种结构化格式可以确保数据被机器读取和精确解析,并无歧义地传入下一步提示,从而减少再次依赖自然语言理解所带来的误差,是构建稳健多步 LLM 系统的关键一环。
实际应用与用例
在构建智能体系统时,提示链的适用范围非常广;其核心价值在于把复杂问题拆解为可顺序执行、便于管理的步骤。以下列举若干实际应用与用例:
1. 信息处理工作流
许多任务需要对原始信息做多步转换。例如:总结文档、抽取关键实体,再用这些实体查询数据库或生成报告。提示链可以是:
- 提示 1:从给定 URL 或文档中提取正文。
- 提示 2:对清洗后的文本做摘要。
- 提示 3:从摘要或原文中抽取特定实体(如人名、日期、地点)。
- 提示 4:用这些实体检索内部知识库。
- 提示 5:生成最终报告,整合摘要、实体与检索结果。
这种方法常见于自动化内容分析、AI 研究助手开发、复杂报告生成等场景。
2. 复杂问答
需要多步推理或信息检索才能回答的复杂问题,是典型场景。例如:「1929 年股市崩盘的主要原因有哪些?政府政策如何应对?」
- 提示 1:识别用户问题里的核心子问题(崩盘原因、政府应对)。
- 提示 2:专门检索 1929 年崩盘原因的相关信息。
- 提示 3:专门检索政府对 1929 年股市崩盘的政策应对信息。
- 提示 4:综合第 2、3 步的信息,形成对原始问题的连贯回答。
这种顺序处理方法,是构建具备多步推理与信息综合能力的 AI 系统的核心。当一个问题无法仅凭单一数据点回答,而是需要经过一系列逻辑步骤,或整合来自多个来源的信息时,就需要这类系统。
例如,一个旨在围绕某个主题生成全面报告的自动研究智能体,往往会执行一种混合式计算工作流:先检索大量相关文章;随后,从各篇文章中抽取关键信息的任务可以按来源并行展开。这个阶段非常适合并行处理,以尽可能提高效率。
然而,各条抽取完成后,流程在本质上变为顺序推进:须先汇总抽取结果,再综合成连贯草稿,最后审阅润色得到终稿;这些后续阶段在逻辑上依赖前一阶段顺利完成。此处正是提示链的用武之地:汇总数据作为综合提示的输入,综合后的文本再作为终稿审阅提示的输入。因此,复杂任务常把「彼此独立的数据收集」交给并行处理,把「综合与润色等相互依赖的步骤」交给提示链。
3. 数据抽取与转换
将非结构化文本转换为结构化格式,通常需要通过迭代式、按顺序推进的修正过程,逐步提高输出的准确性与完整性。
- 提示 1:尝试从发票类文档中抽取特定字段(如姓名、地址、金额)。
- 处理:检查必填字段是否齐全、格式是否符合要求。
- 提示 2(条件式):若字段缺失或格式错误,构造新提示让模型专门补全或纠正,并可附上失败尝试的上下文。
- 处理:再次校验结果;必要时重复。
- 输出:给出已抽取且已校验的结构化数据。
这种顺序处理方法特别适用于从表单、发票、邮件等非结构化来源中进行信息抽取与分析。例如,在处理 PDF 表单这类复杂 OCR 场景时,采用拆解后的多步方法通常更有效。
可以先用大语言模型从文档图像中完成主要的文字抽取;再对原始输出进行数据规范化,例如把 one thousand and fifty 转成数值 1050。而精确算术一直是 LLM 的明显短板,因此在后续步骤中,可以把所需计算交给外部计算器工具:由 LLM 判断需要执行什么计算,把规范化后的数字传给工具,再将精确结果接回流程。通过将文字抽取、数据规范化和外部工具调用串联起来,这条链路往往比单次 LLM 查询更能稳定地产出准确结果。
4. 内容生成工作流
复杂内容的写作通常是过程性任务,一般会拆成若干阶段:初步构思、结构提纲、起草与后续修订。
- 提示 1:根据用户大致兴趣生成 5 个选题。
- 处理:由用户选定其一,或自动择优。
- 提示 2:基于选定主题生成详细提纲。
- 提示 3:按提纲第一点撰写一节草稿。
- 提示 4:按提纲第二点撰写一节草稿,并附上上一节作为上下文;提纲其余各点依此类推。
- 提示 5:通读全文,就连贯性、语气与语法做审阅与润色。
该方法用于多种自然语言生成任务,包括自动创作叙事、技术文档及其他结构化文本。
5. 带状态的对话智能体
完整的状态管理架构通常比单纯的顺序串联更复杂,但提示链仍然是维持对话连续性的基础手段:它会把每一轮对话都构造成一个新的提示,并系统性地纳入先前交互中的信息或已经抽取出的实体。
- 提示 1:处理用户话语 1,识别意图与关键实体。
- 处理:用意图与实体更新对话状态。
- 提示 2:基于当前状态生成回复,和/或识别下一步需要的信息。
- 后续轮次重复;每轮新的用户话语都会触发一条利用累积对话历史(状态)的链。
这一原则是对话智能体开发的基石,使系统能够在长程、多轮对话中保持上下文和连贯性。只有保留对话历史,系统才能理解并恰当地回应那些依赖先前交流信息的用户输入。
6. 代码生成与精炼
生成可运行代码通常是多阶段过程:需要把问题分解为一串离散逻辑操作,再逐步执行。
- 提示 1:理解用户对代码函数的请求,生成伪代码或提纲。
- 提示 2:根据提纲撰写初稿代码。
- 提示 3:识别潜在错误或改进点(可用静态分析工具或另一次 LLM 调用)。
- 提示 4:针对问题重写或精炼代码。
- 提示 5:补充文档或测试用例。
在 AI 辅助软件开发等场景中,提示链的价值在于把复杂编码任务拆成一系列可管理的子问题,降低模型在每一步上的操作负担。更重要的是,可在模型调用之间插入确定性逻辑,支持中间数据处理、输出校验与工作流内的条件分支,从而把原本容易导致不可靠或不完整结果的单次多面请求,转为由底层执行框架管理的有序操作序列。
7. 多模态与多步推理
在分析包含多种模态的数据时,通常需要把问题拆分为更小、由提示驱动的子任务。例如,要解读一张图像,而图中同时包含嵌入文字、用于标注特定文字片段的标签,以及解释各标签含义的表格数据,就很适合采用这种方法。
- 提示 1:从用户提供的图像中提取并理解文字内容。
- 提示 2:将图像中的文字与对应标签关联起来。
- 提示 3:结合表格解释已收集信息,得出所需输出。
动手代码示例
实现提示链,既可以采用脚本中直接的顺序函数调用,也可以借助专门管理控制流、状态和组件集成的框架。LangChain、LangGraph、Crew AI 与 Google Agent Development Kit(ADK)等工具,都为构建和执行这类多步流程提供了结构化环境,尤其适合较复杂的系统架构。
演示可选用 LangChain 与 LangGraph:二者核心 API 明确面向操作链与操作图的组合。LangChain 提供线性序列的基础抽象;LangGraph 在此基础上支持有状态与循环计算,便于实现更复杂的智能体行为。本例聚焦基本的线性序列。
下列代码实现两步提示链,充当数据处理流水线:第一阶段解析非结构化文本并抽取信息;第二阶段接收抽取结果,并转为结构化数据格式。
要复现本流程,须先安装所需依赖,可使用如下命令:
pip install langchain langchain-community langchain-openai langgraph注意:langchain-openai 可替换为其他模型提供商的对应包。随后须为所选语言模型服务(如 OpenAI、Google Gemini、Anthropic)在执行环境中配置必要的 API 凭证。
import os
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

# For better security, load environment variables from a .env file
# from dotenv import load_dotenv
# load_dotenv()
# Make sure your OPENAI_API_KEY is set in the .env file

# Initialize the Language Model (using ChatOpenAI is recommended)

llm = ChatOpenAI(temperature=0)

# --- Prompt 1: Extract Information ---

prompt_extract = ChatPromptTemplate.from_template(
    "Extract the technical specifications from the following text:\n\n{text_input}"
)

# --- Prompt 2: Transform to JSON ---

prompt_transform = ChatPromptTemplate.from_template(
    "Transform the following specifications into a JSON object with 'cpu', 'memory', and 'storage' as keys:\n\n{specifications}"
)

# --- Build the Chain using LCEL ---
# The StrOutputParser() converts the LLM's message output to a simple string.
extraction_chain = prompt_extract | llm | StrOutputParser()

# The full chain passes the output of the extraction chain into the 'specifications'
# variable for the transformation prompt.
full_chain = (
    {"specifications": extraction_chain}
        |
    prompt_transform
        |
    llm
        |
    StrOutputParser()
)

# --- Run the Chain ---

input_text = "The new laptop model features a 3.5 GHz octa-core processor, 16GB of RAM, and a 1TB NVMe SSD."

# Execute the chain with the input text dictionary.
final_result = full_chain.invoke({"text_input": input_text})
print("\n--- Final JSON Output ---")
print(final_result)这个 Python 示例展示了如何借助 LangChain 处理文本:两个独立的提示分别负责从输入字符串中抽取技术规格,以及将这些规格整理成 JSON。语言模型交互通过 ChatOpenAI 完成,StrOutputParser 则确保输出被转换为可用的字符串格式。LangChain 表达式语言(LCEL)用于把提示与模型自然地串联起来。extraction_chain 负责抽取信息;full_chain 则把抽取结果作为下一步转换提示的输入。示例还提供了一段描述笔记本电脑的样本文本,经 full_chain 两步处理后,最终打印出一个包含抽取和格式化结果的 JSON 字符串。
上下文工程与提示工程
上下文工程(见图 1)是指在生成 token 之前,为 AI 模型系统性地设计、构建并提供完整的信息环境。这一方法论认为,模型输出的质量与其说主要取决于模型架构本身,不如说更多取决于提供给它的上下文是否丰富、充分。
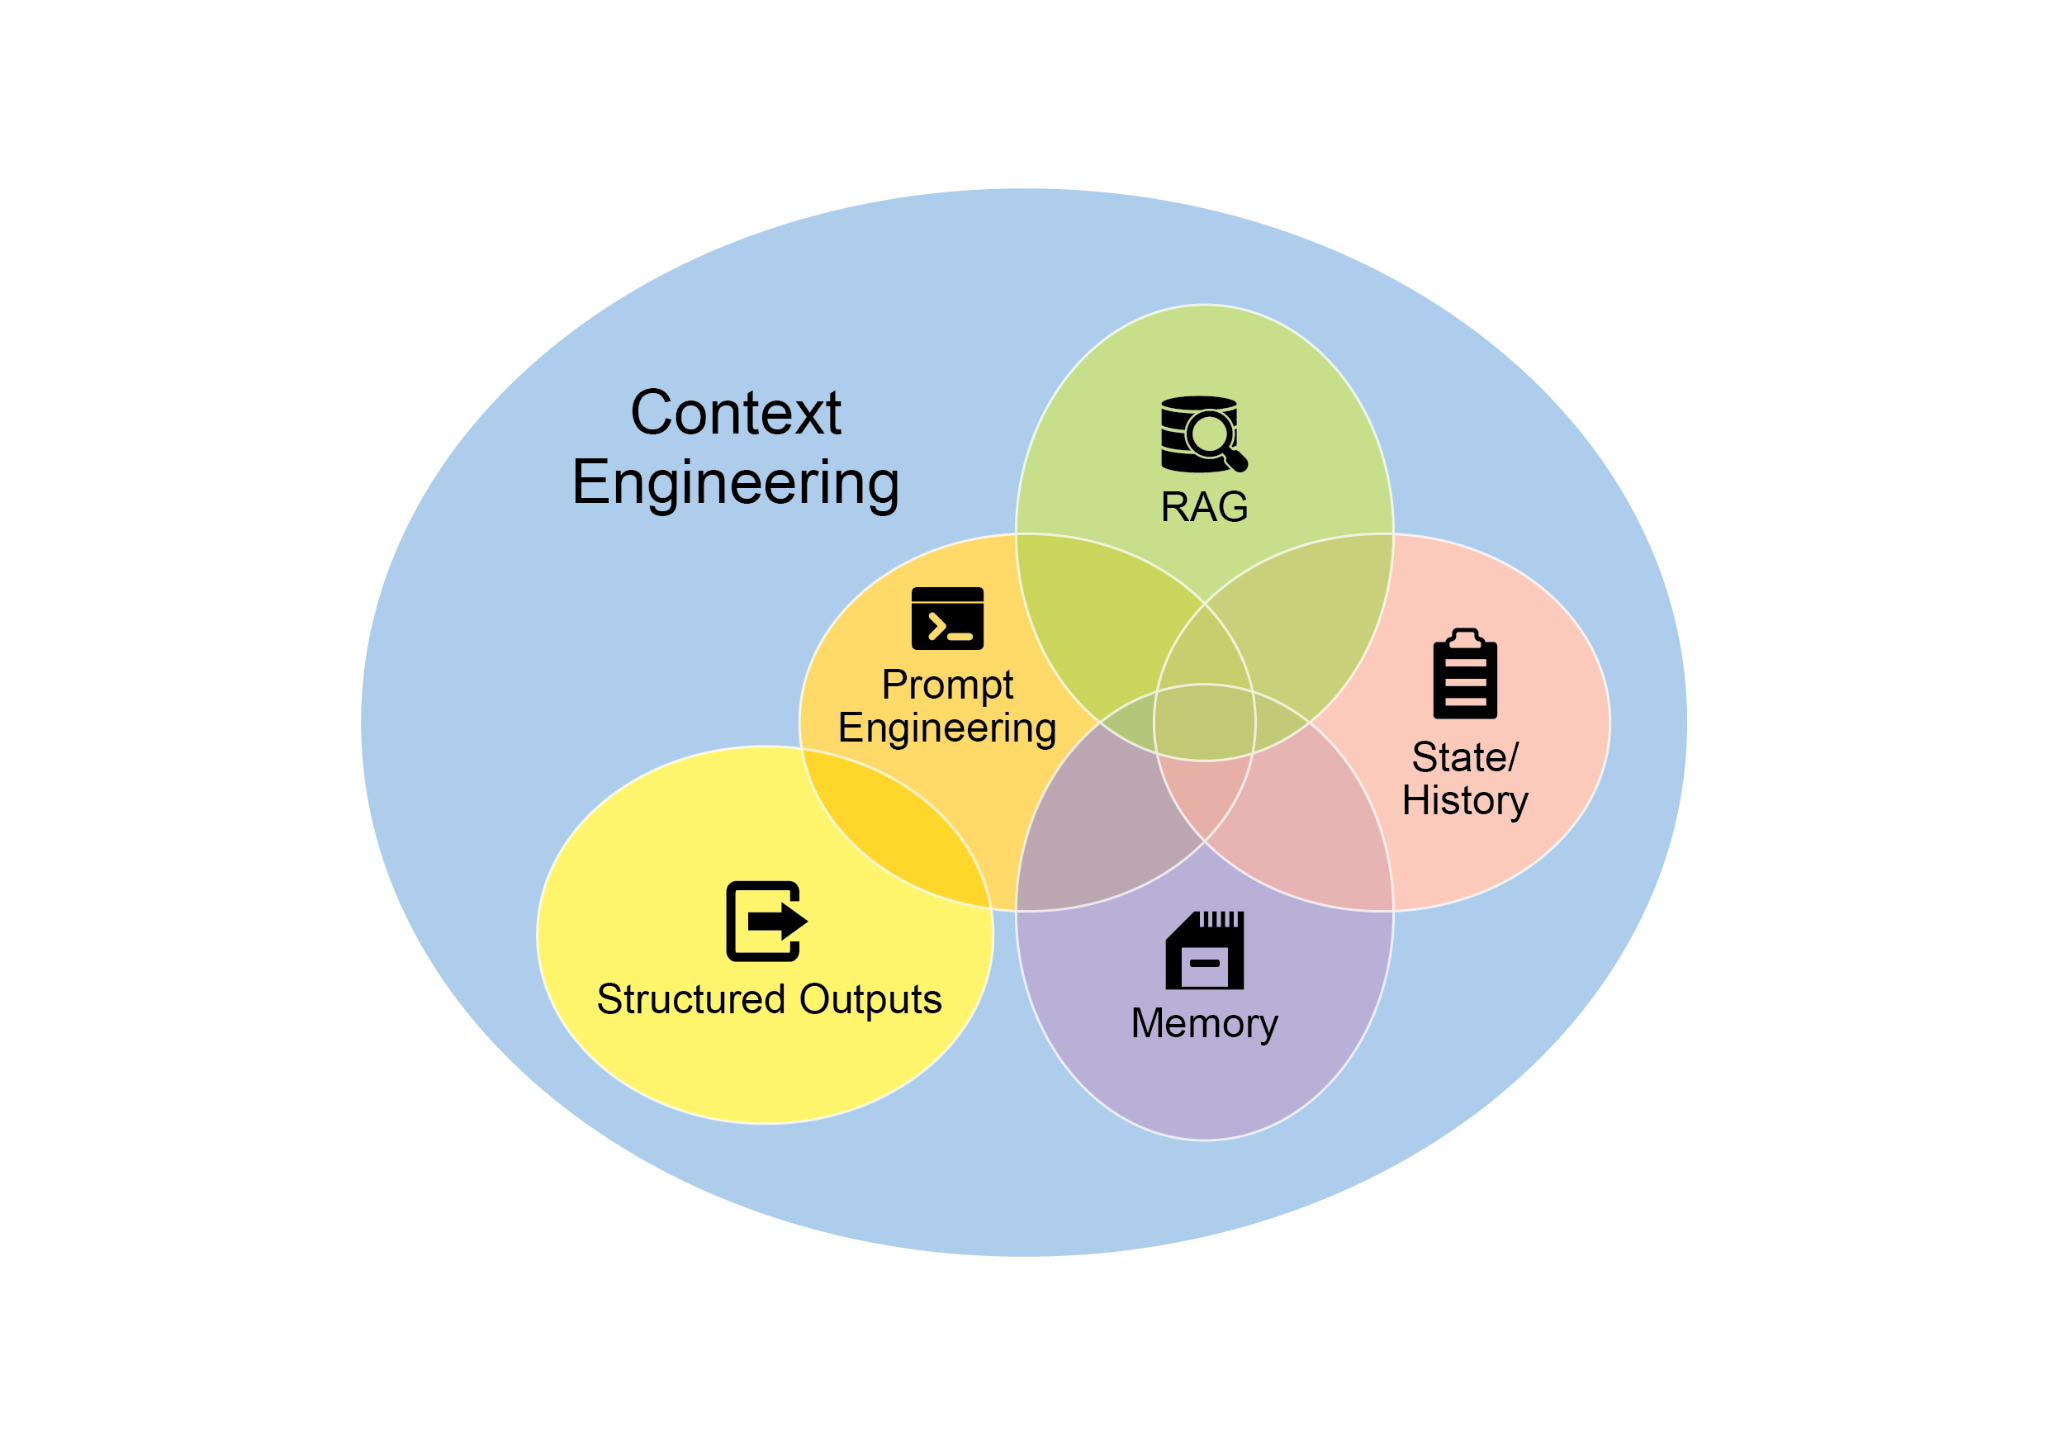
图 1:上下文工程是为 AI 构建丰富、完备信息环境的学科;上下文质量是支撑高阶智能体表现的主要因素之一。
与主要聚焦于优化用户即时提问措辞的传统提示工程相比,上下文工程代表了一次显著的扩展:它把关注范围延伸到多层信息,例如用于定义 AI 运行参数的系统提示(基础指令集),如「你是技术写作者;语气必须正式、精确。」上下文还会通过外部数据得到进一步丰富,包括检索文档(AI 从知识库中主动获取信息以支撑回答,例如拉取项目的技术规格),以及工具输出(AI 调用外部 API 获得的实时结果,例如查询日历判断用户是否有空)。这些显式数据会与用户身份、交互历史、环境状态等关键隐式数据结合起来。其核心原则是:即使是先进模型,如果获得的环境视图过于狭窄或上下文构建不当,也会表现不佳。
因此,这种做法把任务从「仅仅回答一个问题」重新定义为「为智能体构建完整的运行图景」。例如,一个经过上下文工程设计的智能体,不会只是回应查询,而会先整合用户的日历空闲情况(工具输出)、与邮件收件人的职业关系(隐式数据)以及过往会议笔记(检索文档),从而生成高度相关、个性化且真正有用的输出。这里的「工程」部分,指的就是在运行时拉取并转换这些数据的稳健流水线,以及用来持续提升上下文质量的反馈回路。
在实现层面,可以借助专门的调优系统,把这一改进过程大规模自动化。例如,Google Vertex AI 的提示优化器能够对照样本输入和预定义评估指标,系统性地评估回答质量,从而提升模型表现,并帮助在不同模型之间迁移提示与系统指令,而无需大量手工改写。向这类优化器提供样本提示、系统指令和模板后,它就能以程序化方式精炼上下文输入,为复杂上下文工程所需的反馈回路提供一种结构化实现手段。
这种结构化方法,正是简单 AI 工具与更成熟、具备上下文感知能力的系统之间的重要分野。它把上下文本身视为核心组成部分,强调智能体知道什么、何时知道,以及如何使用这些信息。通过这种方式,模型才能对用户意图、历史和当前环境形成更完整的理解。归根结底,上下文工程是把无状态聊天机器人推进为高能力、具备情境感知能力的系统的关键方法论。
速览
是什么: 复杂任务若在单条提示内处理,常使 LLM 不堪重负并出现明显性能问题;认知负荷升高会增加忽视指令、丢失上下文、生成错误信息等风险。单一的整体提示 monolithic prompt 难以同时管好多重约束与顺序推理,导致输出不可靠、不准确,无法覆盖多面请求的各个侧面。
为什么: 提示链 通过把复杂问题拆成更小、彼此衔接的子任务序列,提供标准化解法。链中每一步用聚焦提示完成特定操作,显著提升可靠性与可控性;上一步输出作为下一步输入,形成逐步逼近最终答案的逻辑工作流。模块化分治使流程更易管理、更易调试,并允许在步骤间整合外部工具或结构化数据。该模式是开发能规划、推理并执行复杂工作流的多步智能体系统的基础。
经验法则: 当一个任务对单条提示来说过于复杂、包含多个明确的处理阶段、需要在步骤之间调用外部工具,或需要构建具备多步推理和状态维护能力的智能体系统时,就适合采用这一模式。
图示摘要:
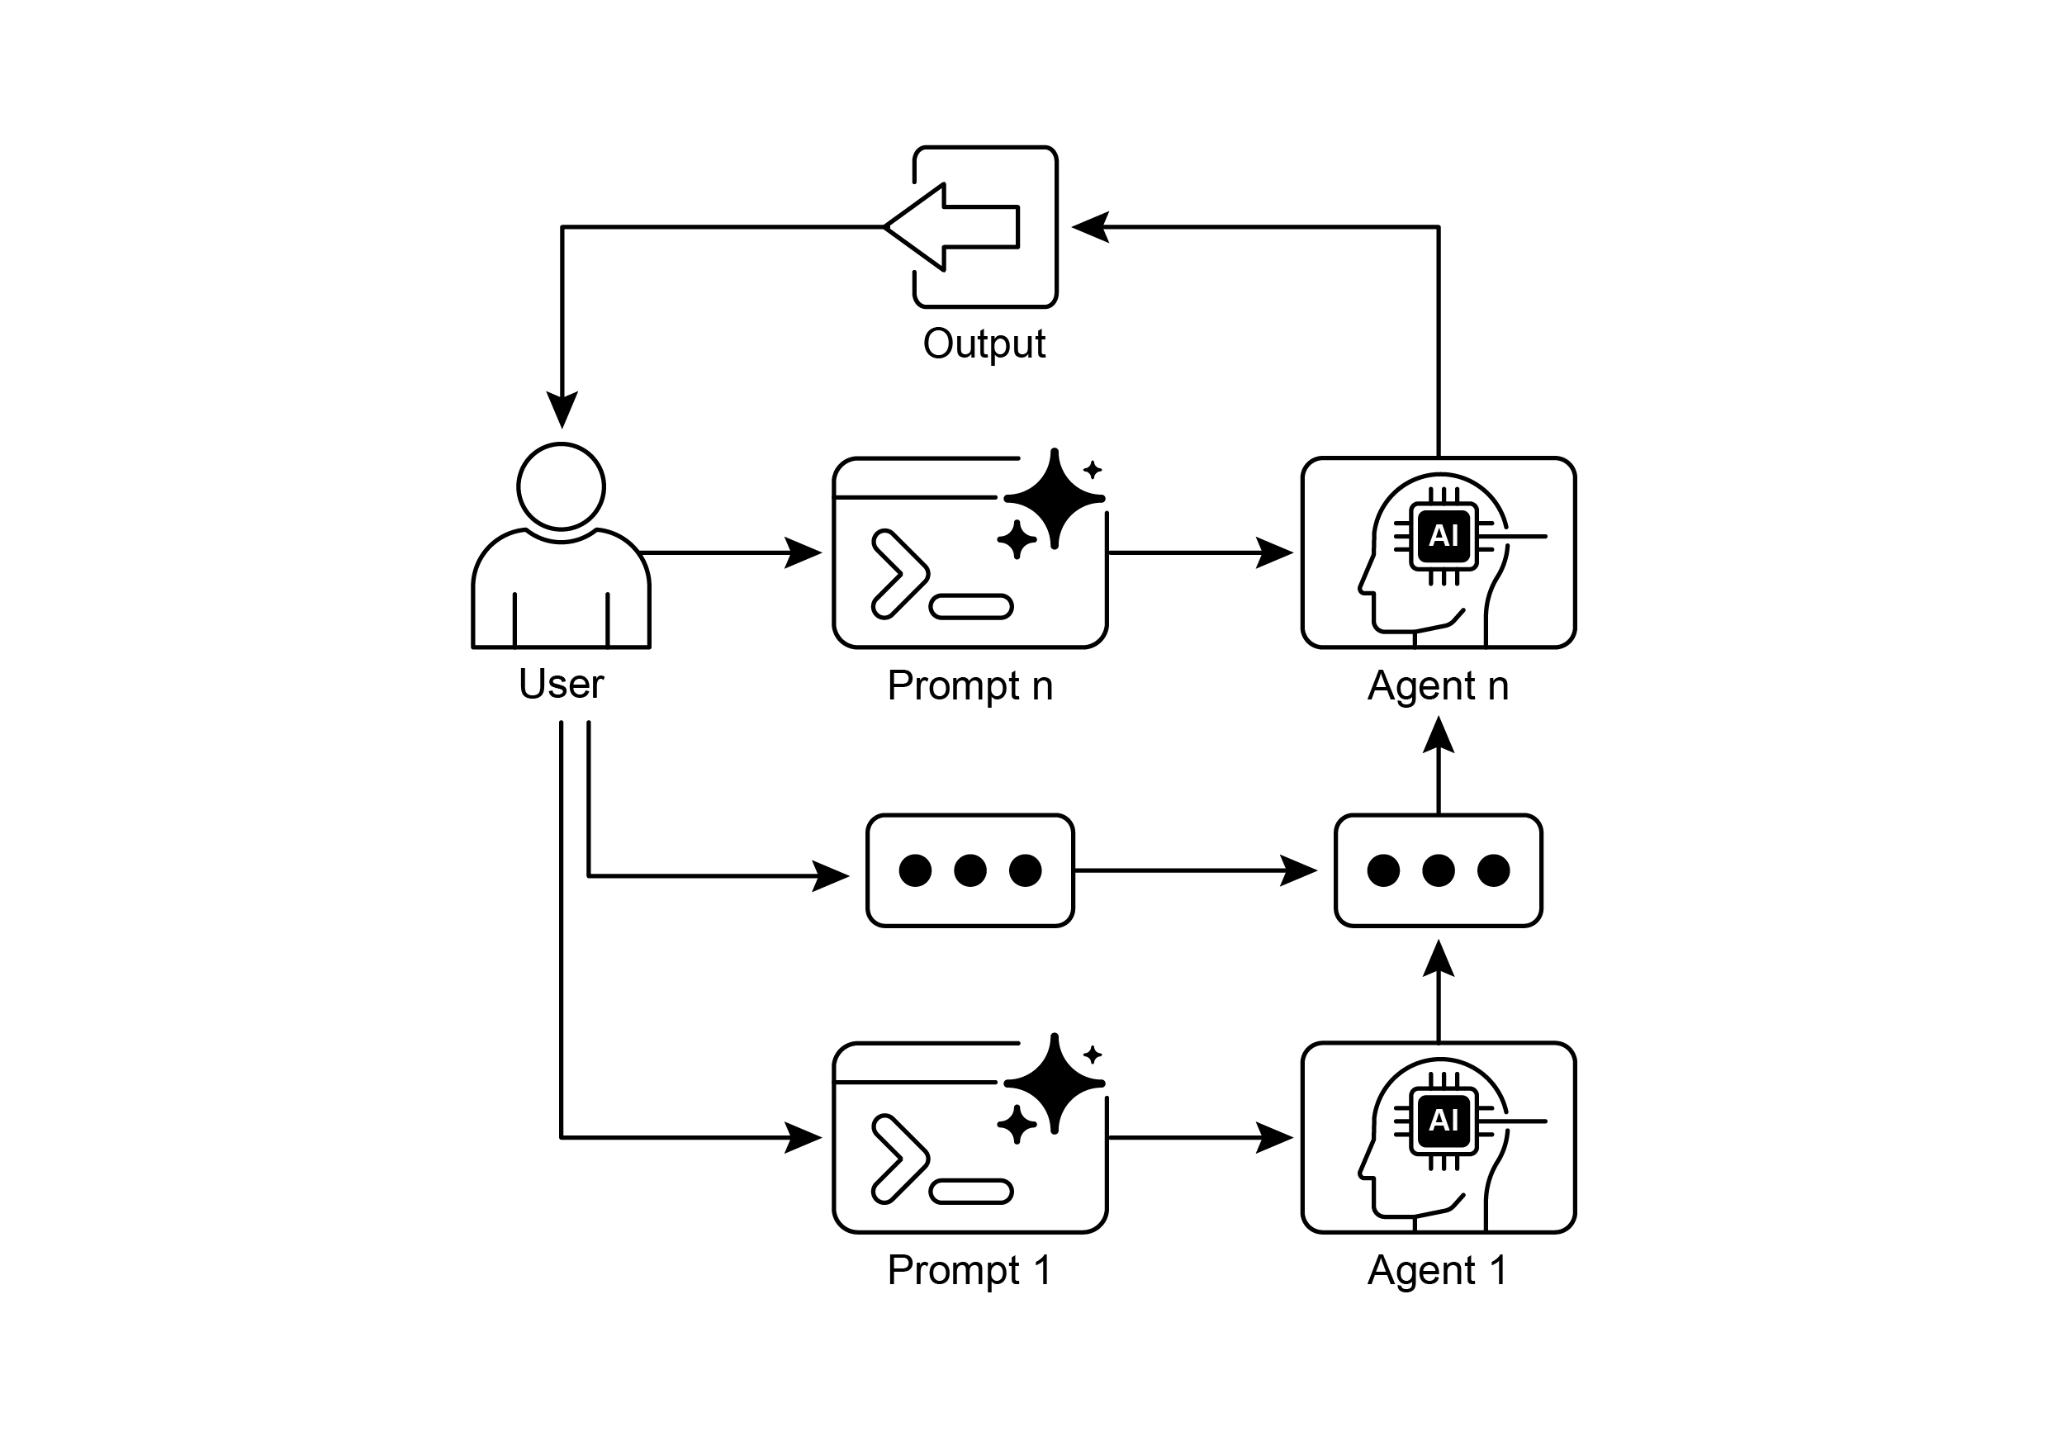
图 2:提示链模式。智能体接收用户发出的一系列提示,每一步的输出都会作为链中下一步的输入。
要点
要点如下:
提示链(Prompt Chaining) 把复杂任务拆成更小、更聚焦的步骤序列;有时也称为流水线模式(Pipeline pattern)。- 链中每一步是一次 LLM 调用或处理逻辑,并以上一步输出为输入。
- 该模式提升与语言模型复杂交互的可靠性与可管理性。
- LangChain/LangGraph 与 Google ADK 等框架提供定义、管理与执行这些多步序列的稳健工具。
结语
通过将复杂问题拆解为一系列更简单、更易处理的子任务,提示链为引导大语言模型提供了一个稳健的框架。这种“分而治之”的策略让模型在每一步只聚焦于单一操作,从而显著提升了输出的可靠性与可控性。作为一种基础模式,它为开发具备多步推理、工具集成和状态管理能力的复杂智能体奠定了基础。归根结底,掌握提示链对于构建稳健、具备上下文感知能力且能够执行远超单条提示所能完成之复杂工作流的系统,至关重要。
参考资料
以下是与提示链相关的英文参考资料: