第 14 章:知识检索(RAG)
大语言模型在生成自然语言方面表现出色,但它的知识边界通常受限于训练语料,难以及时获取最新信息、企业内部资料或高度专业化的细节。检索增强生成(RAG,Retrieval Augmented Generation)正是为弥补这一短板而提出的。它让 LLM 在作答前先检索外部、具备时效性且与当前语境相关的材料,再把回答建立在可核验的依据之上,从而提升准确性和相关性。
对智能体来说,这一点尤为关键:它的行动和答复必须建立在可核验、可更新的数据之上,而不能只依赖模型参数中静态而模糊的记忆。这样,系统才能更稳健地完成复杂任务,例如依据最新制度回答员工问题,或在下单前核对实时库存。通过把外部知识接入系统,RAG 能让智能体从单纯「会对话」进一步变成真正「能执行任务」的数据驱动助手。
知识检索(RAG)模式概览
「知识检索(RAG)」的核心,是在模型生成回答前先访问外部知识库,从而显著扩展其能力边界。模型不再只能依赖预训练参数中的静态记忆,而是可以像人类查阅资料一样主动检索外部信息。因此,它给出的答案通常更贴近问题,也更具时效性,更便于核对来源。
当用户向带有 RAG 的系统提问时,请求并不会直接送入 LLM。系统会先在外部知识源中检索相关内容,例如文档库、业务数据库或网页索引。这里通常用的不是简单的关键词匹配,而是能够理解查询意图的语义检索。系统随后提取最相关的若干文本片段(chunk),把它们拼接回原始提示,完成上下文增强,再将增强后的提示交给模型。由于多了一层可引用的证据支撑,回答不仅自然流畅,也更不容易偏离事实。
RAG 的收益非常直接:模型可以利用训练截止日期之后产生的新事实;通过把回答建立在检索片段之上,能明显降低幻觉风险;同时还可以接入企业内部 wiki、制度库等私有知识源。另一个重要优势是「可引用」能力。段落级溯源让读者可以回到原始材料自行核验,从而同时提升可信度和可审计性。
若要理解 RAG 的工作机制,首先应把握以下几个核心组成部分(见图 1):
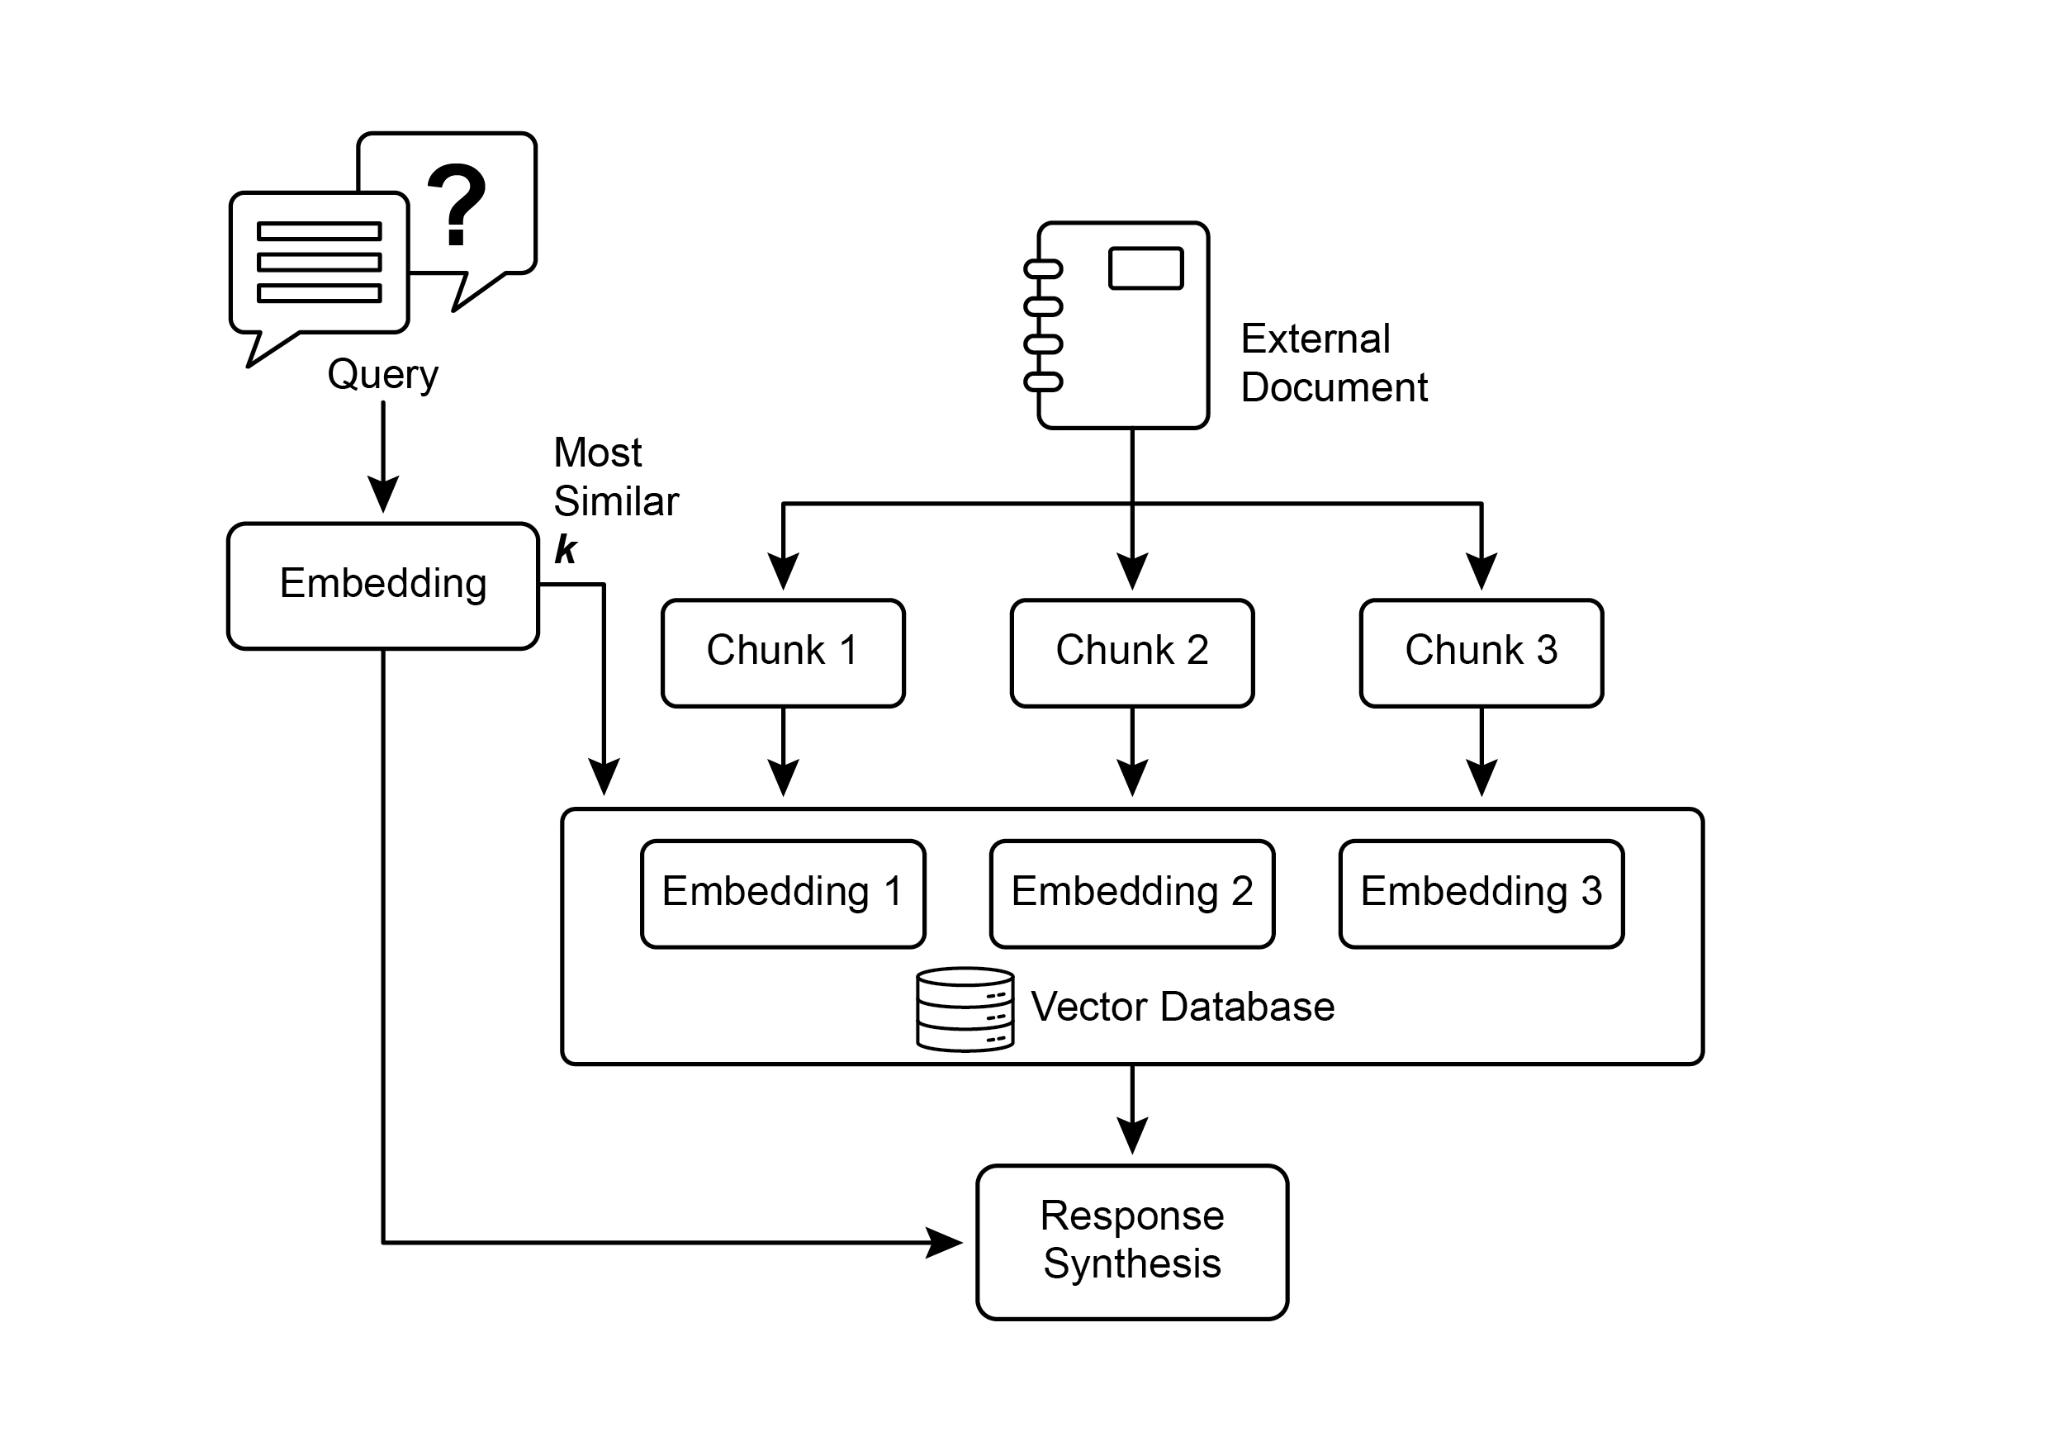
图 1:RAG 核心概念——分块、嵌入与向量数据库
嵌入
在 LLM 体系中,嵌入(embedding)是把词语、句子或整篇文本表示为一组数字,也就是向量。这样,机器就能在几何空间中度量语义距离:含义越接近的文本,其向量位置通常也越接近。教材中常用二维示意,例如「cat」可能位于 (2,3),「kitten」则靠近 (2.1,3.1),而「car」会落在更远的位置如 (8,1)。在真实系统中,嵌入通常处在数百甚至上千维的空间里,以容纳更细粒度的语义差异。
文本相似度
文本相似度衡量的是两段文本在多大程度上彼此接近。它既可以从词面重合度来理解,也可以从深层语义是否一致来判断。RAG 检索正依赖这一能力,在知识库中找出与用户问题最相关的片段。比如 What is the capital of France? 与 Which city is the capital of France? 虽然措辞不同,但表达的是同一个问题,优秀的相似度模型仍会给出较高评分。在工程实践中,这通常通过双方 embedding 的距离或相似度来计算。
语义相似度与距离
语义相似度更进一步,关注的是「表达的是否是同一概念」,而不仅仅是「是否使用了相同词语」。语义距离则与之相反:相似度越高,距离越小。RAG 中的向量检索,本质上就是寻找与查询 embedding 距离最近的文档片段。例如 a furry feline companion 与 a domestic cat 几乎不共享关键词,但语义模型仍会把它们映射到相邻的向量位置。正是依赖这种「理解含义」的搜索方式,系统才能在用户换一种说法时,依旧召回知识库中真正相关的内容。
文档分块
分块(chunking)是指把长文档切分成较小、可管理的片段后再入库。如果把整本 50 页的手册作为一个整体送入模型,不仅成本高,也容易引入大量无关噪声;而按章节、段落甚至句子切分后,「安装指南」与「故障排查」就可以分别组织。这样,用户查询具体故障时,系统只需召回排障相关片段,速度和准确性都会更好。完成分块后,检索的主路径通常是向量搜索:利用 embedding 找出语义上最接近用户问题的片段;BM25 这类基于词频排序的传统方法依然有价值,尤其适用于专有名词或型号等字面匹配场景。工程实践中常见「向量 + BM25」的混合检索,以兼顾字面精确匹配与语义泛化能力。
向量数据库
向量数据库是专门为存储 embedding 并执行近邻检索而设计的。关键词检索擅长基于词面匹配进行搜索,却难以理解 furry feline companion 实际上是在描述「cat」;向量检索则按照语义接近程度来寻找结果。用户查询被向量化之后,数据库可借助 HNSW 等索引结构,在数百万级向量中快速定位语义邻近项。因此,即便用户换一种表达方式,也仍有较高概率召回正确片段。简而言之,传统检索偏向「搜字」,向量检索更接近「搜义」。具体实现既包括 Pinecone、Weaviate 等托管服务,也包括 Milvus、Qdrant、Chroma 等开源方案,还可以通过为 Redis、Elasticsearch、Postgres(借助 pgvector)等系统增加向量能力来实现。其底层效率常依赖 FAISS、ScaNN 等库。
RAG 的挑战
RAG 虽然能力强大,但也面临不少挑战。回答所需证据往往分散在多个片段、多个文档之中;如果检索器只返回少量片段,模型就可能给出不完整的答案。系统效果也高度依赖分块策略和排序质量,一旦噪声片段过多,LLM 反而更容易被误导。面对多源信息相互冲突的情况,如何有效综合仍然是开放问题。在工程层面,知识库需要事先完成切分、向量化并写入专用存储,后续还要持续同步更新,尤其是在处理不断演进的 wiki 或动态文档时,否则知识很快就会过时。与此同时,整条链路也会带来额外的延迟、成本和 prompt token 消耗。
总体而言,RAG 让模型从「只依赖训练集记忆」演进为「能够边检索边作答」的系统,是提升可靠性和可用性的重要一步。它通过在生成前插入检索环节,弥补了静态 LLM 的核心短板;embedding、语义相似度、关键词/混合检索以及合理的分块策略,共同决定了系统能否准确找到相关材料;向量数据库则负责在大规模场景下支撑高效近邻搜索。虽然碎片化证据和冲突信息仍是难题,但只要检索和引用环节设计得当,回答就能既贴合语境又便于核验,从而显著提升可信度。
GraphRAG
GraphRAG 将「图结构」引入检索管线。它不只计算向量近邻,还会沿着实体(节点)与关系(边)进行路径推理,因此尤其适合处理需要多跳推理的问题。传统 RAG 的一个弱点,在于难以把分散在多篇文档中的信息有效拼接起来;而图结构恰恰擅长把离散事实组织成关联网络,因此生成的回答通常更连贯,也更具上下文完整性。
典型场景包括在金融领域把公司、事件与指标组织成关系网络,或在科研中挖掘基因、疾病与通路之间的关联。它的代价在于知识图谱的构建、对齐和增量更新成本都较高,也高度依赖领域专家;与纯向量方案相比,GraphRAG 的架构更重、链路更长,效果又几乎完全取决于图谱的质量和覆盖度。因此,它更适合处理多跳推理、强关系依赖的问题;如果需求只是快速完成段落级检索,标准 RAG 往往更具性价比。
Agentic RAG
Agentic RAG(图 2)是在标准 RAG 之上叠加一层具备推理能力的编排机制。它不再只是「检索 + 拼接 prompt」,而是让智能体承担结果质检与知识精炼的角色,主动评估首轮召回是否足够新、足够准、足够全。下面四个情景正体现了这一能力。
其一,是反思与信源排序。用户询问「我司的远程办公政策」时,朴素 RAG 可能同时召回 2020 年的旧博文和 2025 年的正式制度文件;而智能体则可以结合元数据、版本信息和发布渠道进行判断,优先保留现行且权威的文档,把过期内容排除在模型上下文之外。
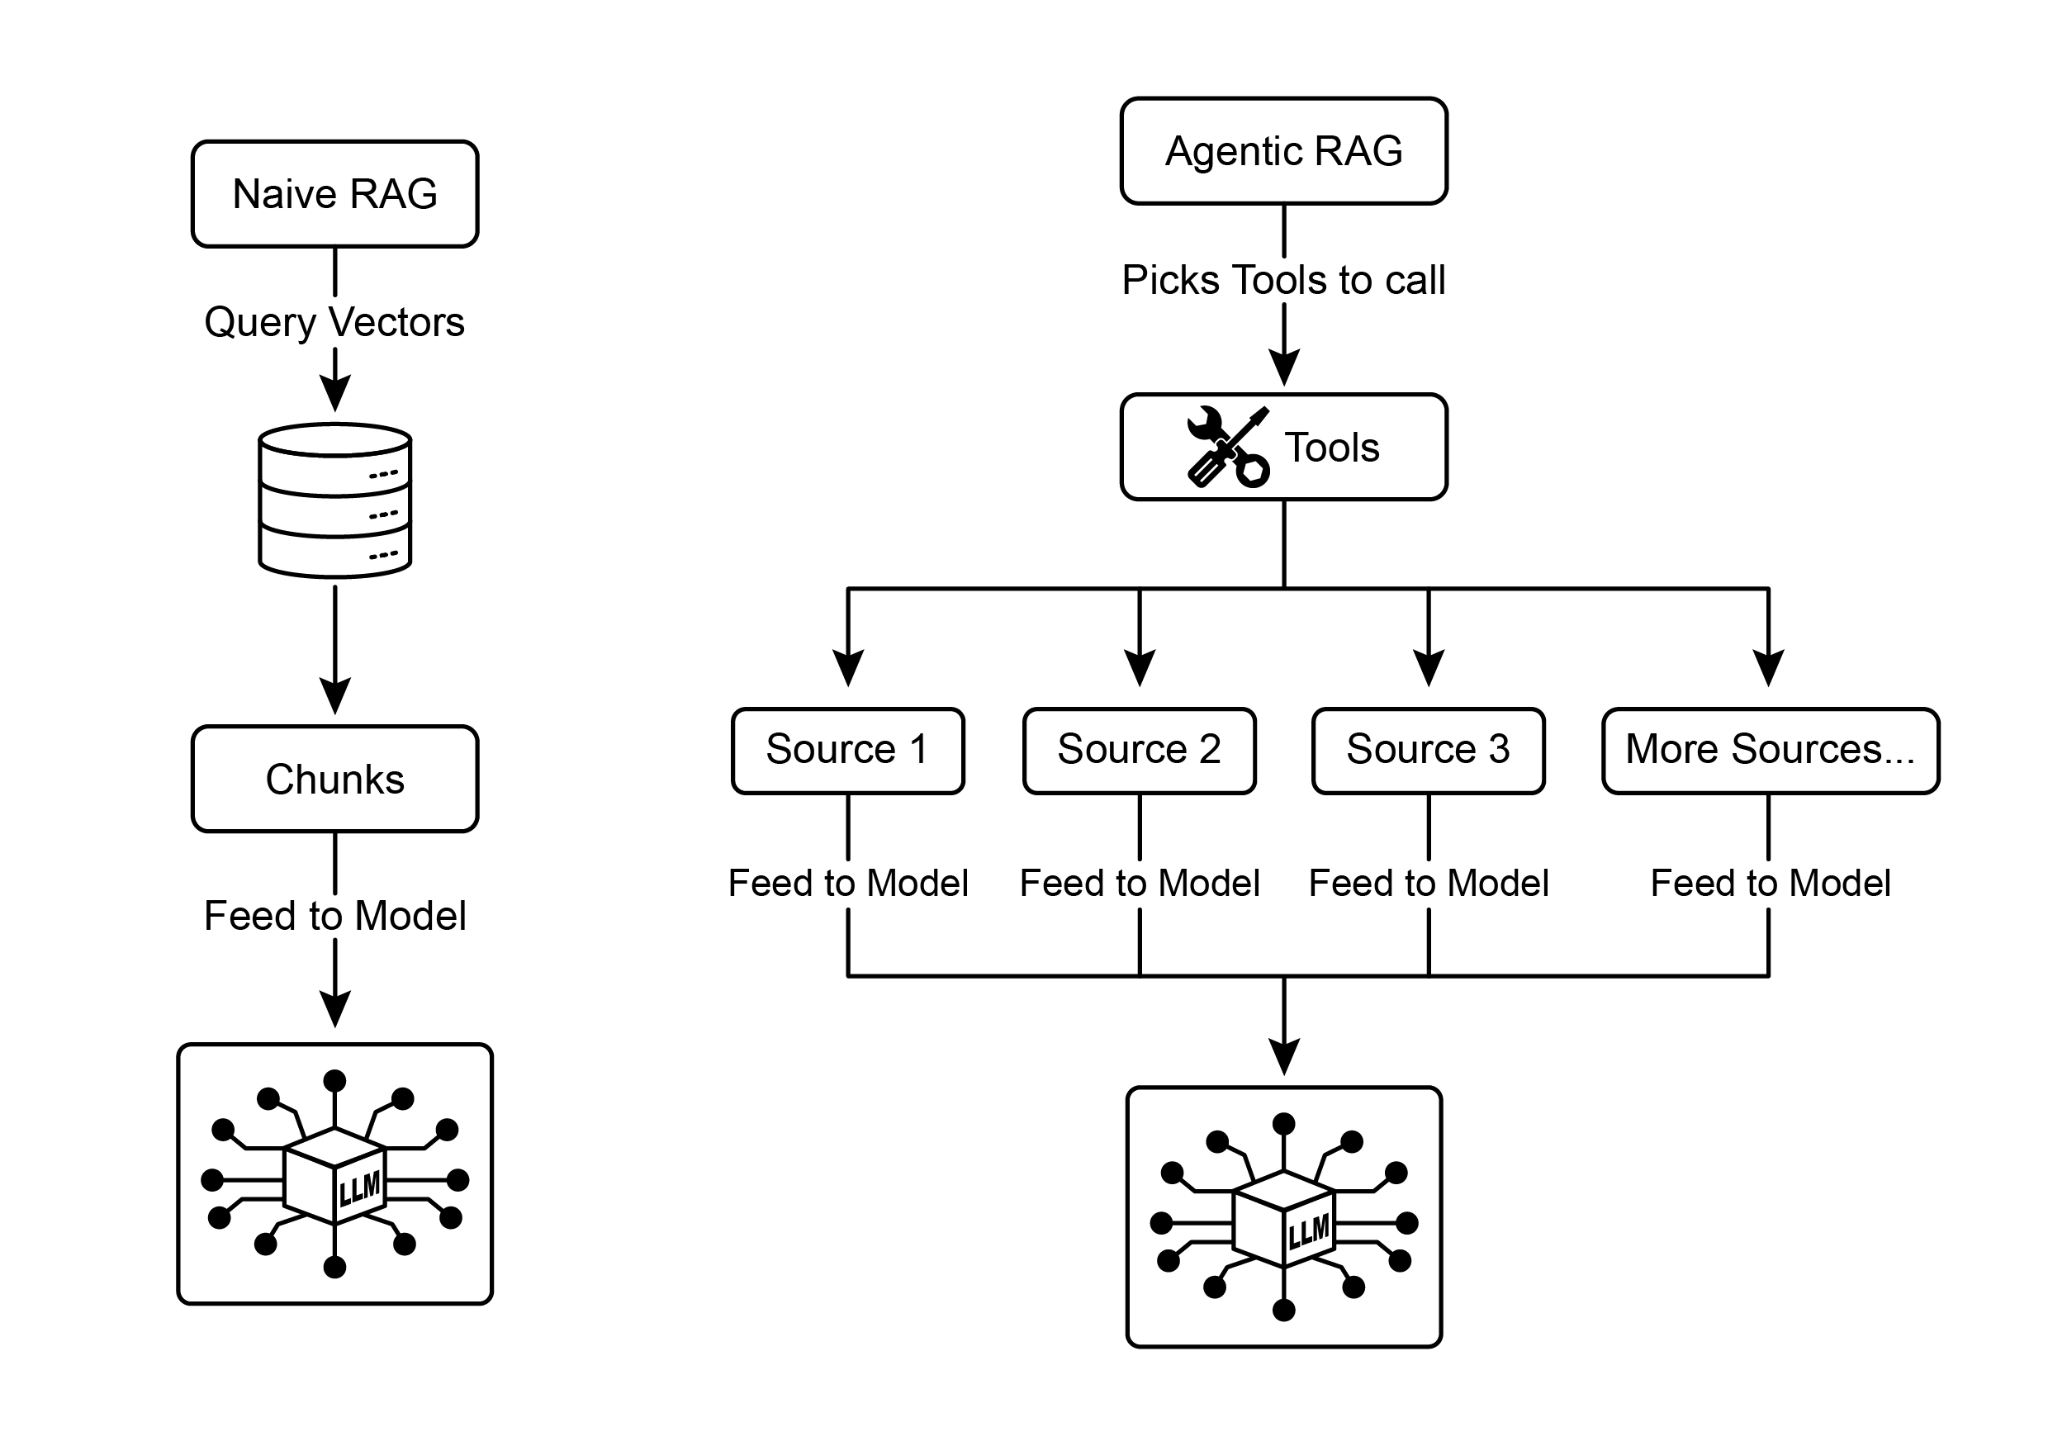
图 2:Agentic RAG 引入推理型智能体,对检索结果做评估、对齐与精炼,以提升最终答复的准确性与可信度。
其二,是冲突消解。分析师询问「Alpha 项目 Q1 预算」时,若一份早期草案写的是 5 万欧元,而另一份定稿财报写的是 6.5 万欧元,智能体就应识别其中矛盾,并结合文档类型与时间戳判断哪一来源更可信。在明确证据优先级后,再交由模型进行总结。
其三,是多步拆解与综合。对于「我们相较于 X 竞品的功能与定价如何」这类对比型问题,系统可以把它拆分为四次检索(我方功能、我方定价、对方功能、对方定价),由智能体先把材料整理成对照式上下文,再交由模型输出结构化结论。这类覆盖范围往往超出了单次向量召回的能力边界。
其四,是知识缺口感知与工具扩展。面对「昨天新品上市后,市场的即时反馈如何」这类问题,如果内部知识库只按周同步,智能体就应意识到现有语料缺乏时效性,转而调用实时搜索或舆情 API 补充证据,再据此组织答案,而不是在证据不足时贸然生成。
Agentic RAG 的挑战
智能体层并非没有代价。决策逻辑、工具权限和失败重试机制都需要工程化实现,其算力消耗和响应延迟通常也显著高于「一次检索、一次生成」的简单流程。更重要的是,如果推理链设计不当,还可能引入新的故障模式,例如无效循环、误删相关片段或误解任务目标,反而损害最终答案质量。
小结
Agentic RAG 把传统流水线升级为能够规划、审视并补足信息缺口的主动系统。它借助推理层完成信源评估、冲突仲裁、子问题拆解和工具调用,从而换取更高的可靠性与分析深度;代价则是系统架构更重、响应时延更长、成本更高,因此需要有意识地加以治理。
实践应用与用例
RAG 正在改变各行业落地 LLM 的方式。它让回答更准确,也更贴近当前语境,而不再停留在泛化的预训练记忆复述上。
常见落点包括:
- 企业搜索 / 内部问答: 将制度、手册、规格书等资料纳入知识库后,员工在咨询 HR、IT 或产品问题时即可先检索再作答,从而减少模型对内部规则的臆测。
- 客服与工单: 将手册、FAQ 与历史工单入库后,系统可基于证据对常见问题给出一致回答,从而降低一线重复劳动。
- 个性化推荐: 不再局限于关键词匹配,而是可根据用户兴趣的 embedding 检索语义相近的内容或商品。
- 新闻与时事: 接入实时信息流后,系统可先检索最新报道再进行摘要,从而避免模型停留在训练截止日期之前的知识状态。
接入外部知识后,LLM 不再只是一个聊天界面,而是可以承担可审计的知识加工与分发职责。
动手代码示例(ADK)
下面通过三个例子展示 RAG 从检索到生成的完整链路。
第一个例子以 Google 搜索作为检索器,把模型输出建立在实时搜索结果之上。RAG 的本质就是「先获取外部证据,再进行生成」,而内置搜索工具正是这一思路最直观的实现方式之一。
from google.adk.tools import google_search
from google.adk.agents import Agent

search_agent = Agent(
    name="research_assistant",
    model="gemini-2.0-flash-exp",
    instruction="You help users research topics. When asked, use the Google Search tool",
    tools=[google_search],
)第二段演示如何在 ADK 中接入 Vertex AI RAG。VertexAiRagMemoryService 指向云端语料资源,SIMILARITY_TOP_K 用于控制召回条数,VECTOR_DISTANCE_THRESHOLD 用于过滤语义距离过远的片段。完成配置后,智能体就可以对托管语料执行持久化向量检索,把 GCP 侧的 RAG 能力嵌入 ADK 流水线,从而更容易生成具备证据支撑的回答。
# Import the necessary VertexAiRagMemoryService class from the google.adk.memory module.
from google.adk.memory import VertexAiRagMemoryService

RAG_CORPUS_RESOURCE_NAME = "projects/your-gcp-project-id/locations/us-central1/ragCorpora/your-corpus-id"

# Define an optional parameter for the number of top similar results to retrieve.
# This controls how many relevant document chunks the RAG service will return.
SIMILARITY_TOP_K = 5

# Define an optional parameter for the vector distance threshold.
# This threshold determines the maximum semantic distance allowed for retrieved results;
# results with a distance greater than this value might be filtered out.
VECTOR_DISTANCE_THRESHOLD = 0.7

# Initialize an instance of VertexAiRagMemoryService.
# This sets up the connection to your Vertex AI RAG Corpus.
# - rag_corpus: Specifies the unique identifier for your RAG Corpus.
# - similarity_top_k: Sets the maximum number of similar results to fetch.
# - vector_distance_threshold: Defines the similarity threshold for filtering results.
memory_service = VertexAiRagMemoryService(
    rag_corpus=RAG_CORPUS_RESOURCE_NAME,
    similarity_top_k=SIMILARITY_TOP_K,
    vector_distance_threshold=VECTOR_DISTANCE_THRESHOLD,
)动手代码示例(LangChain)
第三个例子展示如何借助 LangChain 与 LangGraph 跑通端到端 RAG 流程。
import os
import requests
from typing import List, Dict, Any, TypedDict

from langchain_community.document_loaders import TextLoader
from langchain_core.documents import Document
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_community.embeddings import OpenAIEmbeddings
from langchain_community.vectorstores import Weaviate
from langchain_openai import ChatOpenAI
from langchain.text_splitter import CharacterTextSplitter
from langchain.schema.runnable import RunnablePassthrough
from langgraph.graph import StateGraph, END

import weaviate
from weaviate.embedded import EmbeddedOptions
import dotenv

# Load environment variables (e.g., OPENAI_API_KEY)
dotenv.load_dotenv()

# Set your OpenAI API key (ensure it's loaded from .env or set here)
# os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"

# --- 1. Data Preparation (Preprocessing) ---

# Load data
url = "https://github.com/langchain-ai/langchain/blob/master/docs/docs/how_to/state_of_the_union.txt"
res = requests.get(url)
with open("state_of_the_union.txt", "w") as f:
    f.write(res.text)

loader = TextLoader("./state_of_the_union.txt")
documents = loader.load()

# Chunk documents
text_splitter = CharacterTextSplitter(chunk_size=500, chunk_overlap=50)
chunks = text_splitter.split_documents(documents)

# Embed and store chunks in Weaviate
client = weaviate.Client(embedded_options=EmbeddedOptions())

vectorstore = Weaviate.from_documents(
    client=client,
    documents=chunks,
    embedding=OpenAIEmbeddings(),
    by_text=False,
)

# Define the retriever
retriever = vectorstore.as_retriever()

# Initialize LLM
llm = ChatOpenAI(model_name="gpt-3.5-turbo", temperature=0)

# --- 2. Define the State for LangGraph ---
class RAGGraphState(TypedDict):
    question: str
    documents: List[Document]
    generation: str

# --- 3. Define the Nodes (Functions) ---
def retrieve_documents_node(state: RAGGraphState) -> RAGGraphState:
    """Retrieves documents based on the user's question."""
    question = state["question"]
    documents = retriever.invoke(question)
    return {"documents": documents, "question": question, "generation": ""}

def generate_response_node(state: RAGGraphState) -> RAGGraphState:
    """Generates a response using the LLM based on retrieved documents."""
    question = state["question"]
    documents = state["documents"]

    # Prompt template from the PDF
    template = """You are an assistant for question-answering tasks. Use the following pieces of retrieved context to answer the question. If you don't know the answer, just say that you don't know. Use three sentences maximum and keep the answer concise.
Question: {question}
Context: {context}
Answer: """
    prompt = ChatPromptTemplate.from_template(template)

    # Format the context from the documents
    context = "\n\n".join([doc.page_content for doc in documents])

    # Create the RAG chain
    rag_chain = prompt | llm | StrOutputParser()

    # Invoke the chain
    generation = rag_chain.invoke({"context": context, "question": question})

    return {"question": question, "documents": documents, "generation": generation}

# --- 4. Build the LangGraph Graph ---
workflow = StateGraph(RAGGraphState)

# Add nodes
workflow.add_node("retrieve", retrieve_documents_node)
workflow.add_node("generate", generate_response_node)

# Set the entry point
workflow.set_entry_point("retrieve")

# Add edges (transitions)
workflow.add_edge("retrieve", "generate")
workflow.add_edge("generate", END)

# Compile the graph
app = workflow.compile()

# --- 5. Run the RAG Application ---
if __name__ == "__main__":
    print("\n--- Running RAG Query ---")
    query = "What did the president say about Justice Breyer"
    inputs = {"question": query}
    for s in app.stream(inputs):
        print(s)

    print("\n--- Running another RAG Query ---")
    query_2 = "What did the president say about the economy?"
    inputs_2 = {"question": query_2}
    for s in app.stream(inputs_2):
print(s)这段 Python 代码把 RAG 流程拆成「建库 → 检索 → 生成」三个阶段:先由 CharacterTextSplitter 进行切块,再通过 OpenAIEmbeddings 与 Weaviate 完成向量化和存储;随后使用 StateGraph 串联 retrieve_documents_node(根据问题检索向量近邻)与 generate_response_node(把上下文注入提示模板,再调用 ChatOpenAI 生成回答)。app.stream 便于观察多步状态流转,演示系统如何产出带有检索证据支撑的回答。
一览
是什么: LLM 虽然具备很强的文本生成能力,但它的知识通常冻结在训练快照中:既不了解实时世界,也无法直接访问私有知识库。因此,回答容易过期、含糊,或缺少领域语境。在那些要求「信息最新且可核对」的场景里,这一限制会直接削弱系统可靠性。
为什么: RAG 提供了一套清晰的方法论:先检索知识库,再把命中的片段拼接进 prompt,相当于让模型在「开卷」条件下作答。证据在场,回答自然更易核验,也更贴近业务事实,从而同步提升整体可信度和可用性。
经验法则: 只要答案必须依赖训练数据之外的特定信息、实时信息或保密信息,就应考虑引入 RAG。内部文档问答、合规客服,以及需要引用出处或支持溯源的写作场景,都是典型应用。
图示摘要:
知识检索模式:智能体向结构化库发起查询并取回记录
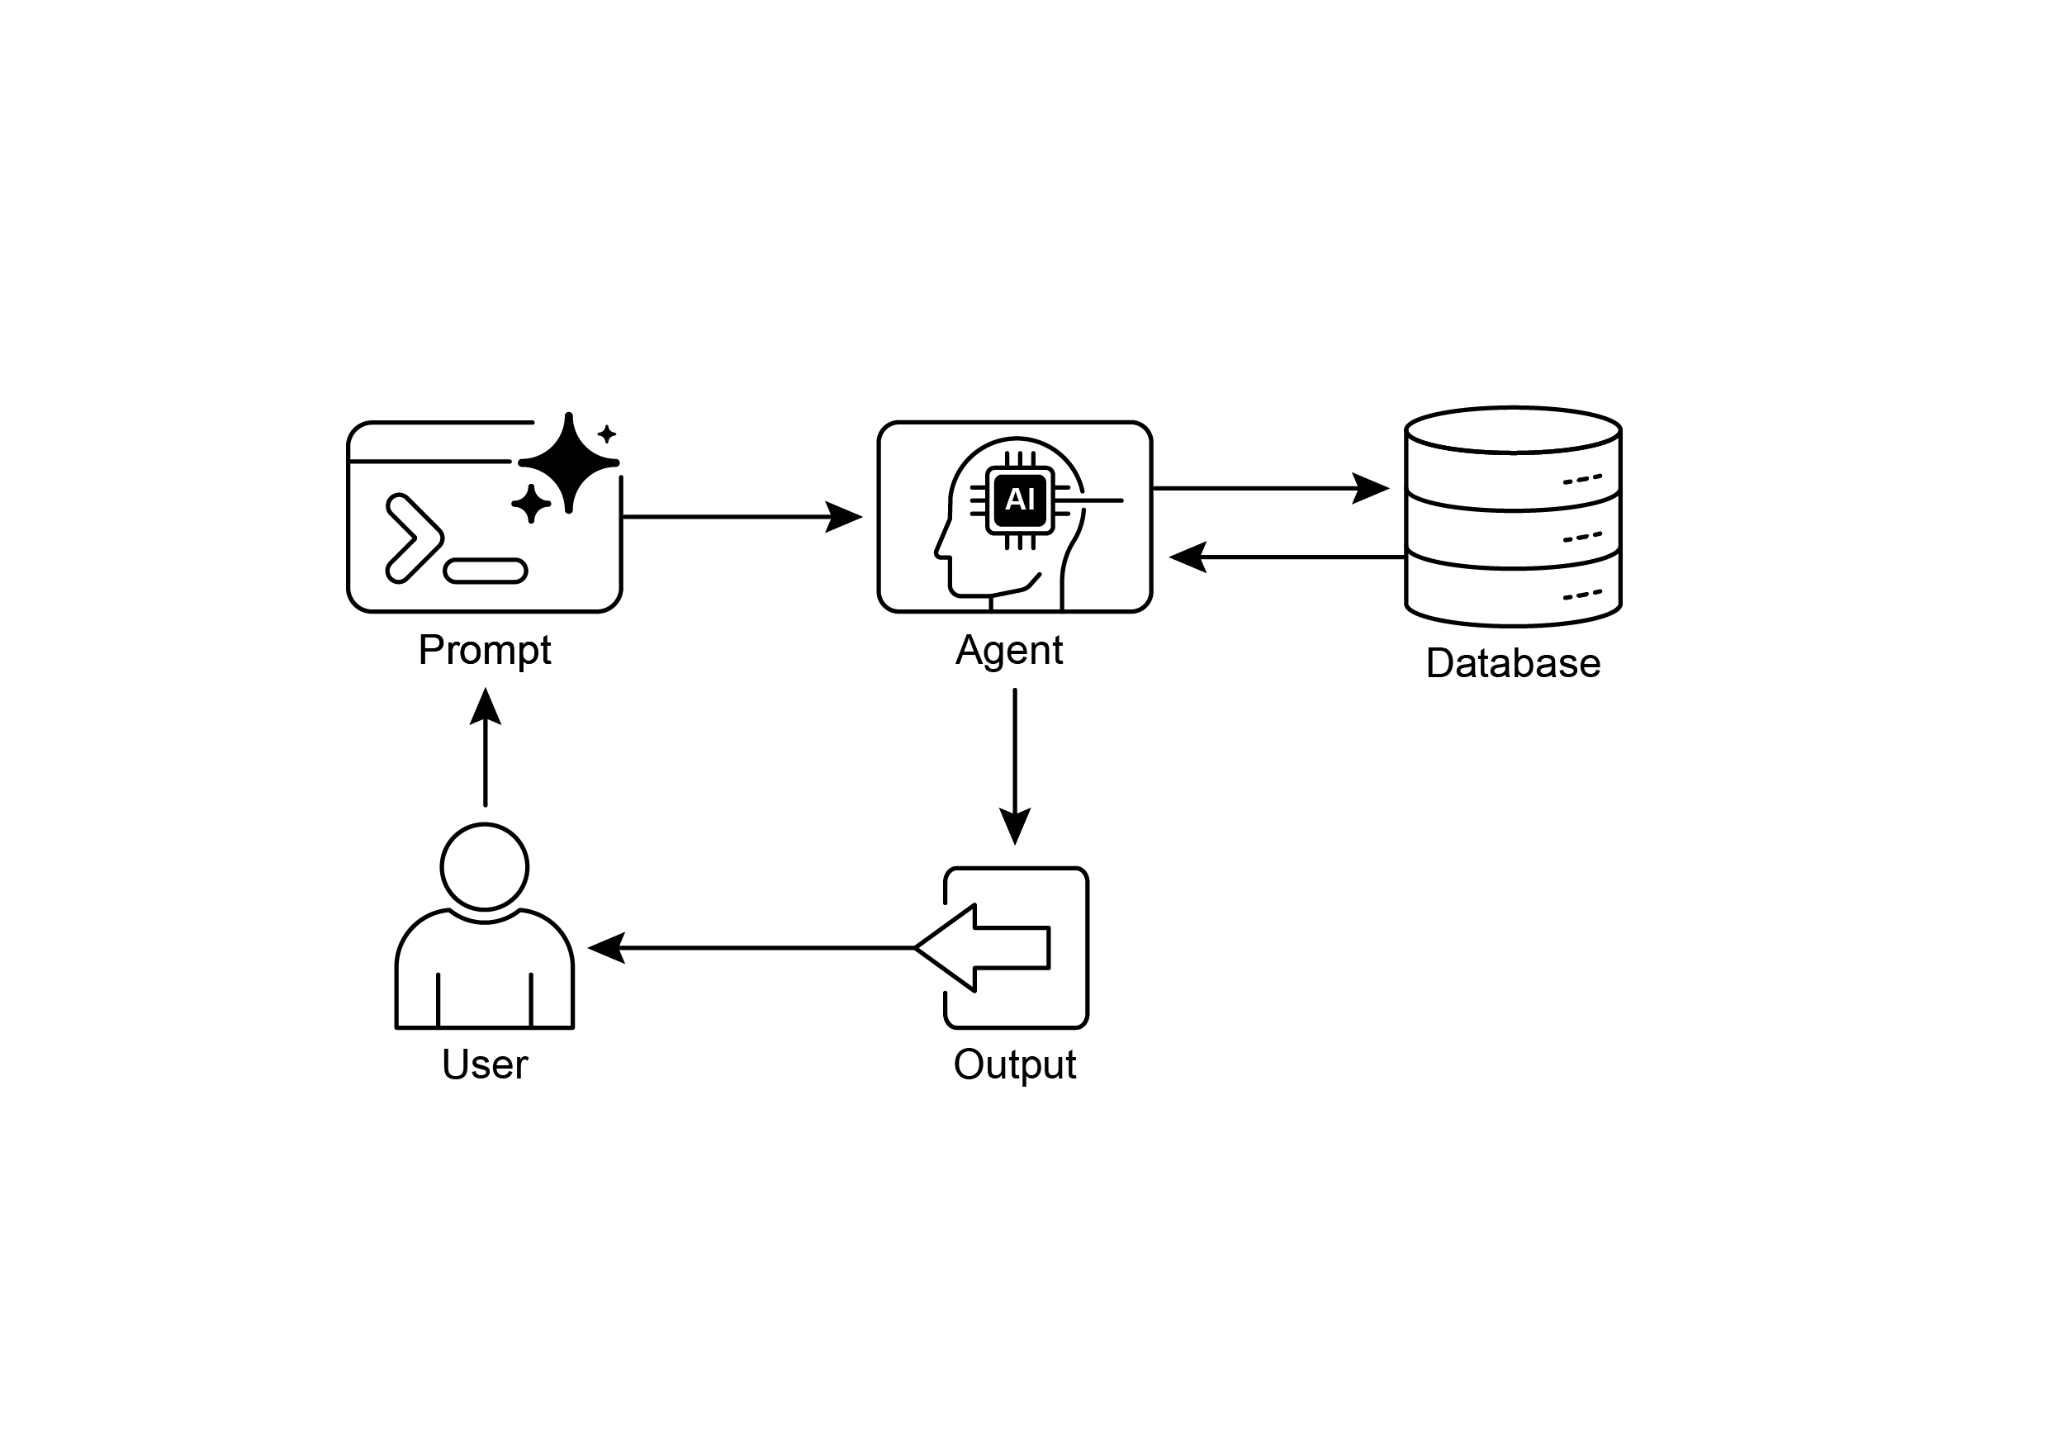
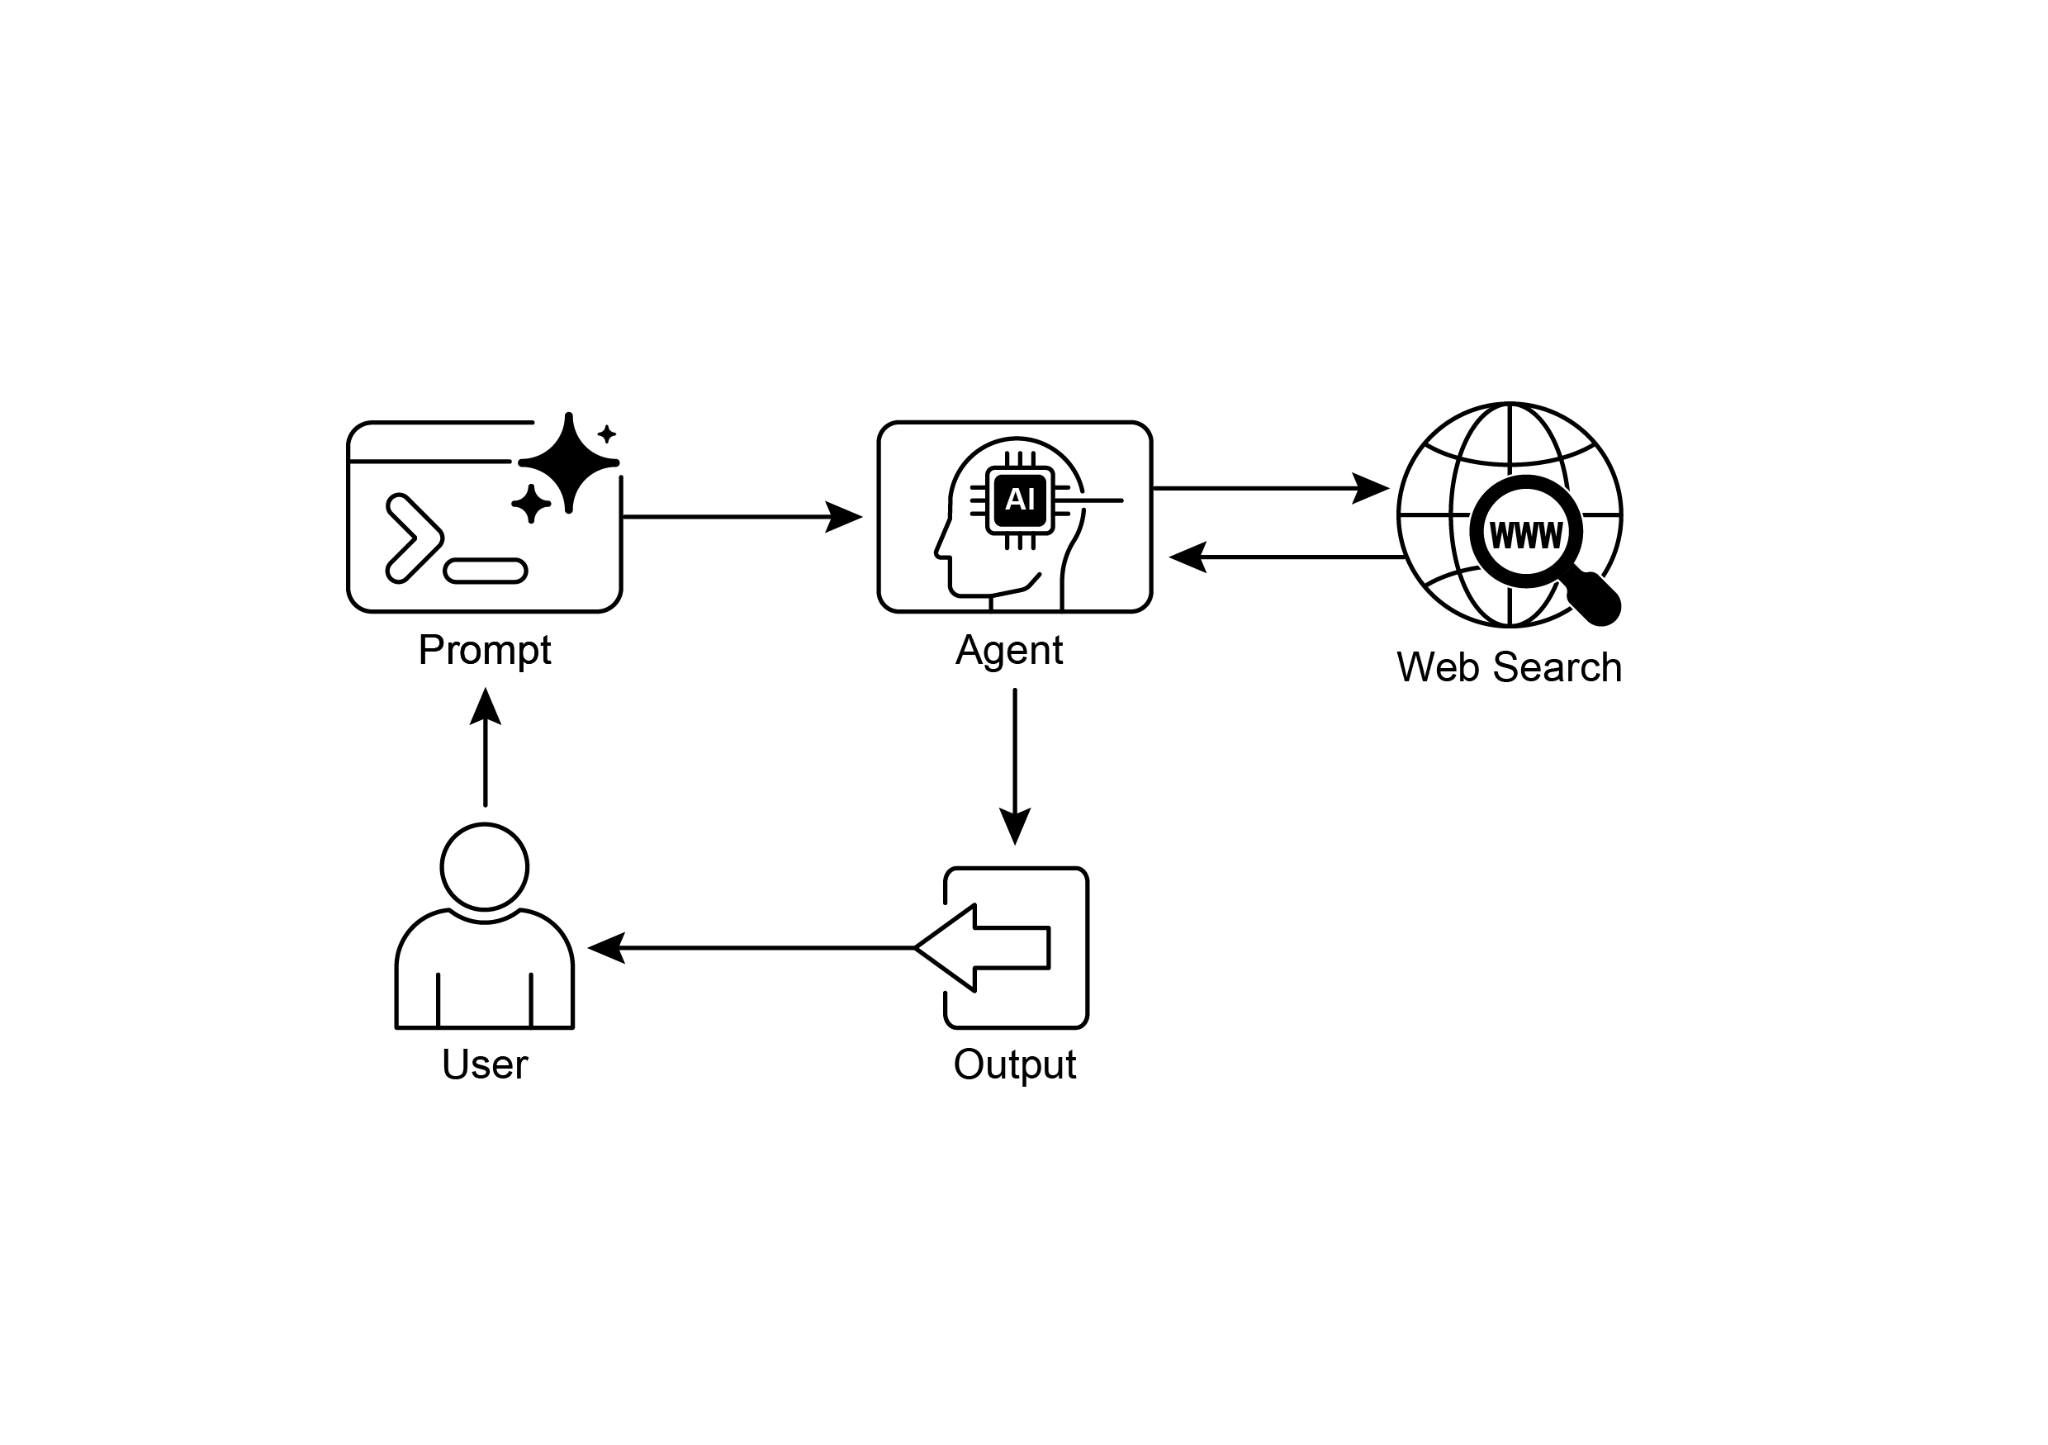
图 3:知识检索模式——智能体应用户问句从公网检索并综合信息
要点
- RAG 的核心,是先检索外部片段,再把片段送入提示,让模型「带着证据说话」。
- 它能缓解训练截止日期带来的知识滞后、私域盲区,并降低胡编概率。
- 片段级引用让答案更可追溯,也更便于审计。
- GraphRAG 用图结构补足多跳推理和多文档综合的短板。
- Agentic RAG 用智能体做质检、消歧、多步查询和工具补洞,以换取更高可靠性。
- 企业搜索、客服、法务检索、个性化推荐等场景都已大量采用这类方案。
结语
总的来看,RAG 通过接入外部知识源,弥补了 LLM 静态记忆的短板。它先检索、后生成,让提示中携带明确证据;embedding、语义检索与向量数据库则共同负责按语义定位相关材料。当答案建立在可验证片段之上时,事实性错误与私域知识盲区都能得到缓解,而引用机制又进一步提升了系统的可信度。
Agentic RAG 进一步叠加推理层,专门处理信源冲突、任务拆解和工具补充数据;GraphRAG 则借助图谱中的显式关系应对多跳综合类问题。两者都需要更高的工程投入,也会带来更高时延,但换来的是回答深度与可信度的显著提升。如今,这些方法已广泛渗透到搜索、客服、内容分发等垂直场景。尽管挑战依然存在,RAG 体系仍是推动 LLM 从「封闭式对话」迈向「基于证据执行任务」的重要路径之一。
参考资料
- Lewis, P., et al. (2020). 《面向知识密集型自然语言处理任务的检索增强生成》(Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks). https://arxiv.org/abs/2005.11401
- Google AI for Developers 文档:《检索增强生成(RAG)概览》(Retrieval Augmented Generation),https://cloud.google.com/vertex-ai/generative-ai/docs/rag-engine/rag-overview
- 《基于图的检索增强生成(GraphRAG)》(Retrieval-Augmented Generation with Graphs (GraphRAG)),https://arxiv.org/abs/2501.00309
- LangChain 与 LangGraph:Leonie Monigatti,《检索增强生成(RAG):从理论到 LangChain 实现》(Retrieval-Augmented Generation (RAG): From Theory to LangChain Implementation),https://medium.com/data-science/retrieval-augmented-generation-rag-from-theory-to-langchain-implementation-4e9bd5f6a4f2
- Google Cloud Vertex AI:《RAG 语料库管理》(RAG Corpus),https://cloud.google.com/vertex-ai/generative-ai/docs/rag-engine/manage-your-rag-corpus#corpus-management