第 21 章:探索与发现
本章讨论一类模式:驱动智能体主动搜寻新信息、发掘新可能,并在运行环境中识别「未知的未知」。它不同于只在既定解空间中被动响应,或做局部优化。它的核心在于,智能体能够主动进入陌生领域、尝试新方法,并沉淀出新的知识与理解。在开放、复杂或快速演化的领域里,静态知识库与硬编码流程往往不足以支撑持续创新;此时,能否不断扩展认知边界,往往决定了智能体能力的上限。
实际应用场景与用例
当代智能体已经能把「先探哪条路」与「怎么探」结合起来:先对候选行动做优先级评估,再按顺序深入复杂环境,挖掘隐藏关联并催化创新。带优先级的探索,让它们既能优化流程,也能产出新知识和新内容。
典型示例如下:
- 科研自动化: 智能体可闭环完成「设计实验—采集数据—解读结果—提出新假设」的流程,用于新材料、候选药物或基础规律发现。
- 博弈与策略生成: 通过搜索博弈树或策略空间,捕捉非常规下法或环境漏洞(AlphaGo 即典型范例)。
- 市场调研与趋势捕捉: 聚合社交媒体、新闻与研报等非结构化信号,提炼趋势、客群行为与商业机会。
- 安全漏洞发现: 对系统与代码库做主动探测,定位缺陷与潜在攻击路径。
- 创意内容生成: 在风格、母题与素材之间组合试错,输出视觉、音乐或文本类作品。
- 个性化教育: 依据学习进度、认知偏好与薄弱点,对知识路径与内容投放动态排序。
Google Co-Scientist(AI 协作科学家)
AI 协作科学家由 Google Research 推出,定位是「计算科学协作体」:它被设计成真实科研流程中的辅助角色,主要支持假设提出、课题论证与实验设计;底层由 Gemini 系列大模型驱动。
它瞄准的正是科研中的典型痛点:文献爆炸、可验证假设难提、实验排期复杂等。系统擅长吞吐与综合海量信息,帮助研究者看见跨文献的潜在关联;把算力密集的探索阶段交给模型后,人类就可以把更多精力放在直觉、判断与方向选择上。
系统架构与方法: 整体采用多智能体拓扑,在流程上模拟实验室中的分工协作。若干专科智能体围绕同一个科研问题各展所长;监督智能体则在异步调度层统一编排,并可按任务规模弹性扩容算力。
核心智能体及其职责划分如下(见图 1):
- 生成智能体(Generation agent): 结合文献检索与「虚拟学术辩论」提出首批假设,拉开探索序幕。
- 反思智能体(Reflection agent): 以审稿人视角审视假设的科学性、原创度与表述质量。
- 排序智能体(Ranking agent): 借助 Elo 式对抗赛在多轮辩论中比较假设强弱并完成排序。
- 演化智能体(Evolution agent): 对头部假设做概念压缩、思想融合与非常规推理,持续迭代版本。
- 邻近智能体(Proximity agent): 构建相似度图,聚类相近想法,帮助研究者在高维假设空间里导航。
- 元评审智能体(Meta-review agent): 汇总各轮评审与辩论,提炼共性模式与改进信号,驱动下一轮迭代。
语言理解、链式推理与内容生成均由 Gemini 支撑;同时系统还引入「测试时算力扩展(test-time compute scaling)」机制,在需要多轮推敲答案时临时加大推理预算。知识侧则融合论文、开放网络和结构化数据库等多源证据。
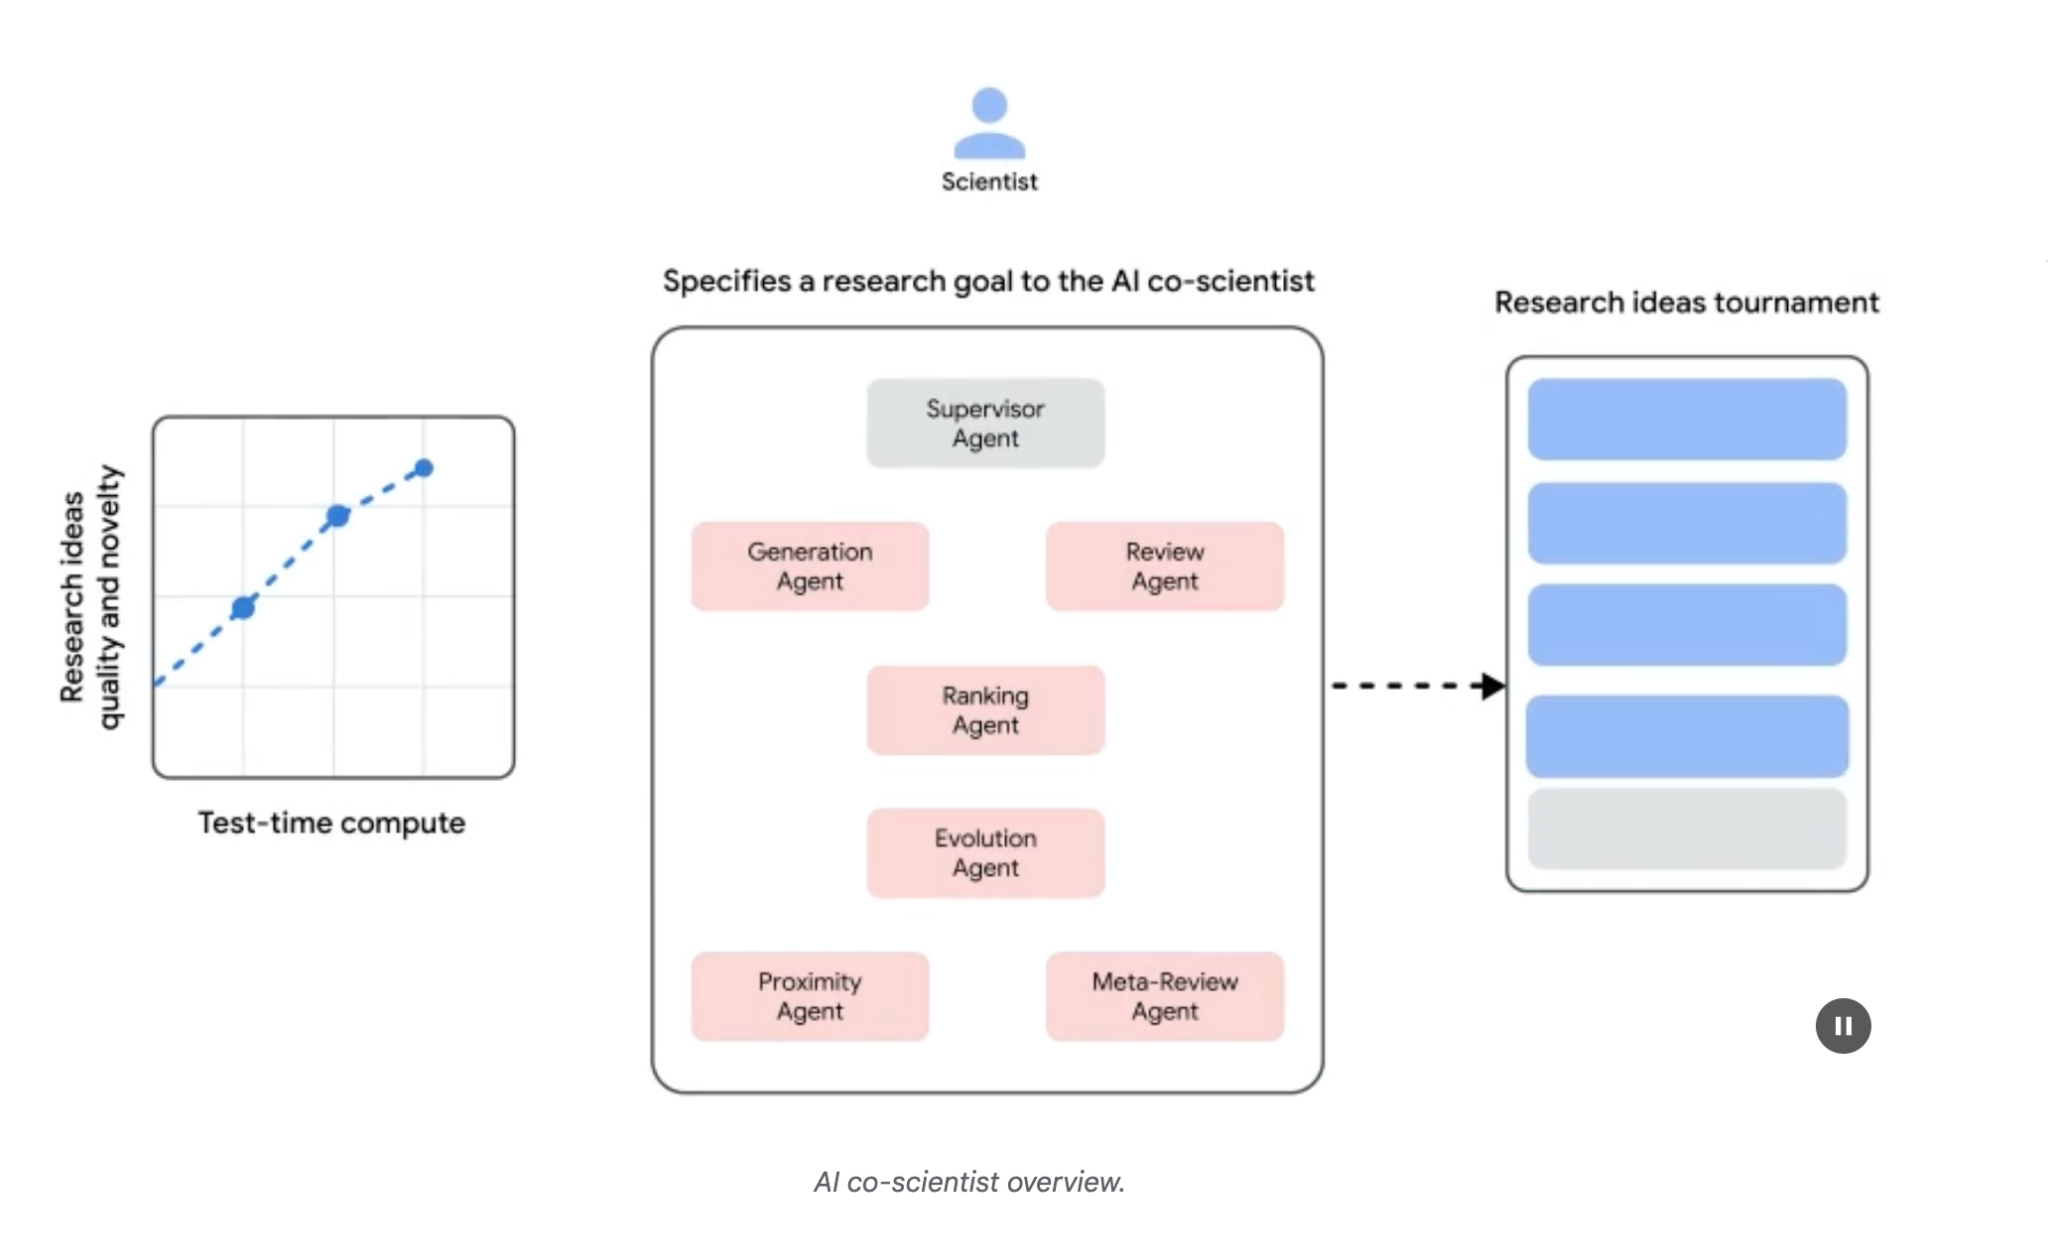
图 1:(作者供图)AI Co-Scientist:从创意到验证
工作流与经典科研节奏基本同构:「生成 → 辩论 → 演化」。科学家提出课题后,系统就会进入自我改进闭环:持续产出假设、互评打分,再进一步精炼;内部既有多智能体互审,也有锦标赛式排序充当质量闸门。
验证与结果: 论文与配套实验表明,该系统在生物医学等方向确有落地价值;评估手段覆盖自动基准、领域专家打分,以及完整的湿实验链路。
自动化与专家评估: 在 GPQA 的高难度子集上,内部 Elo 分数与真实准确率高度一致,「diamond set」的 top-1 达到 78.4%。对 200 多个研究目标的统计也显示,只要增加测试时算力,假设质量就会稳定提升,Elo 仍可作为量化指标。在 15 道精选难题上,系统整体优于同期 SOTA 模型以及人类专家给出的「最佳猜测」。在小规模盲评中,生物医学同行认为它的提案比基线模型更新颖、潜在影响力也更高;六名肿瘤专家也对 NIH Specific Aims 风格的药物重定位草案给出了高分。
端到端实验验证:
药物重定位: 面向急性髓系白血病(AML),模型给出了多条候选分子;像 KIRA6 这类建议,在公开 AML 临床前文献中几乎找不到先例。随后的体外实验显示,KIRA6 等同批推荐在临床相关浓度下,可显著抑制多种 AML 细胞系活力。
新靶点发现: 在肝纤维化场景下,系统指向一组新的表观遗传调控因子。人源肝类器官实验复现了预测:靶向这些因子的化合物展现明确抗纤维化效应,其中一款已是 FDA 批准的老药,为重定位提供捷径。
抗菌耐药性: 在一项独立任务中,系统只用两天就给出了首选假设,而且与某团队尚未发表、却耗时十余年才完成实验验证的结论一致:可移动遗传元件 cf-PICIs 可能通过结合多种噬菌体尾部蛋白来拓宽宿主谱。换言之,模型在没有任何内幕信息的情况下,「撞」上了真实世界的新知。
增强与局限: 它的产品哲学是 人机共研,而不是一键替代科学家。用户可以用自然语言输入洞见、纠偏方向,在 scientist-in-the-loop 框架里共同推进探索。局限也很现实:训练语料以开放获取文献为主,付费墙背后的关键论文可能缺席;阴性结果本就稀缺,模型也更难学到「此路不通」的经验;此外,它仍受制于 LLM 固有的幻觉与事实漂移问题。
安全: 安全被嵌入默认路径。研究问题在入库前就会先做政策扫描,生成出的假设也要经过二次过滤,以避免系统被滥用于危险实验。对抗性测试集(约 1200 条恶意目标)显示,其拒绝策略整体上较为稳健。团队也在通过 Trusted Tester Program 逐步扩大试用范围,以收集真实滥用场景的反馈,继续迭代护栏。
动手代码示例
接下来用 Agent Laboratory(Samuel Schmidgall,MIT 许可)来看探索型智能体如何落地。
Agent Laboratory 是一套自主科研工作流编排器。它的目标是把机械环节交给专职 LLM,让人类把脑力留给问题建模与批判性反思,而不是简单替代研究员。
框架内置 AgentRxiv,这是一个面向自治科研智能体的去中心化知识库,支持论文级产物的发布、获取与协同迭代。
典型流水线被拆成四个阶段:
- 文献综述: 专科智能体自动抓取并批判性阅读相关论文,依托 arXiv 等索引构建可检索的知识基础。
- 实验: 多智能体协同撰写实验方案、清洗数据、执行实验并解读指标;Python 负责代码生成与执行,Hugging Face 提供模型能力,整个过程支持根据中间结果滚动优化。
- 报告撰写: 将实验洞见与文献证据融合,按学术体例排版,并可挂接 LaTeX 生成正式稿件与插图。
- 知识共享: 通过 AgentRxiv 让不同智能体彼此复用并持续改进历史成果,形成开放式的累积创新。
模块化拆分带来了算力和工具链层面的弹性。它的设计原则是「人类掌握方向,系统承担执行」:通过自动化提升吞吐,而不是削弱人类判断。
代码分析: 受篇幅所限,这里无法逐行拆解代码,只列几个关键设计抓手;更细的实现细节,建议读者自行克隆仓库继续追踪。
评判机制: 为了逼近人类审稿体验,系统实现了 三评审联评:三名自治智能体分别强调实验扎实度、领域影响力与创意新颖度,多维打分后再汇总。相比单一的标量奖励,这种做法更能捕获质性差异。
class ReviewersAgent:
    def __init__(self, model="gpt-4o-mini", notes=None, openai_api_key=None):
        if notes is None:
            self.notes = []
        else:
            self.notes = notes
        self.model = model
        self.openai_api_key = openai_api_key

    def inference(self, plan, report):
        reviewer_1 = "You are a harsh but fair reviewer and expect good experiments that lead to insights for the research topic."
        review_1 = get_score(
            outlined_plan=plan,
            latex=report,
            reward_model_llm=self.model,
            reviewer_type=reviewer_1,
            openai_api_key=self.openai_api_key
        )

        reviewer_2 = "You are a harsh and critical but fair reviewer who is looking for an idea that would be impactful in the field."
        review_2 = get_score(
            outlined_plan=plan,
            latex=report,
            reward_model_llm=self.model,
            reviewer_type=reviewer_2,
            openai_api_key=self.openai_api_key
        )

        reviewer_3 = "You are a harsh but fair open-minded reviewer that is looking for novel ideas that have not been proposed before."
        review_3 = get_score(
            outlined_plan=plan,
            latex=report,
            reward_model_llm=self.model,
            reviewer_type=reviewer_3,
            openai_api_key=self.openai_api_key
        )

return f"Reviewer #1:\n{review_1}, \nReviewer #2:\n{review_2}, \nReviewer #3:\n{review_3}"每位评审智能体都绑定了定制化的系统提示词,显式模拟真实审稿人的关注清单,例如相关性、论证链条、事实核查与总体贡献等。通过把人类评审流程模板化,系统希望在自动评分中保留接近人工审稿的细粒度判断。
def get_score(outlined_plan, latex, reward_model_llm, reviewer_type=None, attempts=3, openai_api_key=None):
   e = str()
   for _attempt in range(attempts):
       try:

           template_instructions = """
           Respond in the following format:

           THOUGHT:
           <THOUGHT>

           REVIEW JSON:
           ```json
           <JSON>
           ```

           In <THOUGHT>, first briefly discuss your intuitions
           and reasoning for the evaluation.
           Detail your high-level arguments, necessary choices
           and desired outcomes of the review.
           Do not make generic comments here, but be specific
           to your current paper.
           Treat this as the note-taking phase of your review.

           In <JSON>, provide the review in JSON format with
           the following fields in the order:
           - "Summary": A summary of the paper content and
           its contributions.
           - "Strengths": A list of strengths of the paper.
           - "Weaknesses": A list of weaknesses of the paper.
           - "Originality": A rating from 1 to 4
             (low, medium, high, very high).
           - "Quality": A rating from 1 to 4
             (low, medium, high, very high).
           - "Clarity": A rating from 1 to 4
             (low, medium, high, very high).
           - "Significance": A rating from 1 to 4
             (low, medium, high, very high).
           - "Questions": A set of clarifying questions to be
              answered by the paper authors.
           - "Limitations": A set of limitations and potential
              negative societal impacts of the work.
           - "Ethical Concerns": A boolean value indicating
              whether there are ethical concerns.
           - "Soundness": A rating from 1 to 4
              (poor, fair, good, excellent).
           - "Presentation": A rating from 1 to 4
              (poor, fair, good, excellent).
           - "Contribution": A rating from 1 to 4
             (poor, fair, good, excellent).
           - "Overall": A rating from 1 to 10
             (very strong reject to award quality).
           - "Confidence": A rating from 1 to 5
             (low, medium, high, very high, absolute).
           - "Decision": A decision that has to be one of the
             following: Accept, Reject.

           For the "Decision" field, don't use Weak Accept,
           Borderline Accept, Borderline Reject, or Strong Reject.
           Instead, only use Accept or Reject.
           This JSON will be automatically parsed, so ensure
           the format is precise.
"""整个实验室模拟的是学院式组织结构:不同智能体分别对应导师、执行者与质检等职能,通过组织化分工提升流程可控性与产出稳定性。
教授智能体(Professor Agent): 承担 PI 角色,负责立项、拆解研究问题,并把子任务下发给其他智能体,对总体路线与里程碑负责。
class ProfessorAgent(BaseAgent):
   def __init__(self, model="gpt4omini", notes=None, max_steps=100, openai_api_key=None):
       super().__init__(model, notes, max_steps, openai_api_key)
       self.phases = ["report writing"]

   def generate_readme(self):
       sys_prompt = f"""You are {self.role_description()} \n Here is the written paper \n{self.report}. Task instructions: Your goal is to integrate all of the knowledge, code, reports, and notes provided to you and generate a readme.md for a github repository."""
       history_str = "\n".join([_[1] for _ in self.history])
       prompt = (
           f"""History: {history_str}\n{'~' * 10}\n"""
           f"Please produce the readme below in markdown:\n")
       model_resp = query_model(model_str=self.model, system_prompt=sys_prompt, prompt=prompt, openai_api_key=self.openai_api_key)
return model_resp.replace("```markdown", "")博士后智能体(PostDoc Agent): 一线执行者,覆盖综述、实验设计、跑数和写初稿;既能写代码也能跑代码,是仓库里大部分研究成果的直接产出者。
class PostdocAgent(BaseAgent):
    def __init__(self, model="gpt4omini", notes=None, max_steps=100, openai_api_key=None):
        super().__init__(model, notes, max_steps, openai_api_key)
        self.phases = ["plan formulation", "results interpretation"]

    def context(self, phase):
        sr_str = str()
        if self.second_round:
            sr_str = (
                f"The following are results from the previous experiments\n",
                f"Previous Experiment code: {self.prev_results_code}\n"
                f"Previous Results: {self.prev_exp_results}\n"
                f"Previous Interpretation of results: {self.prev_interpretation}\n"
                f"Previous Report: {self.prev_report}\n"
                f"{self.reviewer_response}\n\n\n"
            )

        if phase == "plan formulation":
            return (
                sr_str,
                f"Current Literature Review: {self.lit_review_sum}",
            )
        elif phase == "results interpretation":
            return (
                sr_str,
                f"Current Literature Review: {self.lit_review_sum}\n"
                f"Current Plan: {self.plan}\n"
                f"Current Dataset code: {self.dataset_code}\n"
                f"Current Experiment code: {self.results_code}\n"
                f"Current Results: {self.exp_results}"
            )

return ""评审智能体(Reviewer Agents): 负责重点审查 PostDoc 提交的研究产出,从方法严谨性、结果可信度与叙事完整度等维度提出批评意见,相当于自动化的同行评议关口。
机器学习工程智能体(ML Engineering Agents): 与博士生角色结对,专注把数据整理到「能喂模型」的状态;代码刻意保持短小可读,并显式吸收上游文献与实验计划里的约束。
"You are a machine learning engineer being directed by a PhD student who will help you write the code, and you can interact with them through dialogue.\n"
"Your goal is to produce code that prepares the data for the provided experiment. You should aim for simple code to prepare the data, not complex code. You should integrate the provided literature review and the plan and come up with code to prepare data for this experiment.\n"软件工程智能体(SWEngineerAgents): 作为 ML 工程师的技术负责人,把关数据管线实现是否贴合实验设计,避免过度工程化,同时确保需求来自真实文献与方案,而不是幻觉字段。
"You are a software engineer directing a machine learning engineer, where the machine learning engineer will be writing the code, and you can interact with them through dialogue.\n"
"Your goal is to help the ML engineer produce code that prepares the data for the provided experiment. You should aim for very simple code to prepare the data, not complex code. You should integrate the provided literature review and the plan and come up with code to prepare data for this experiment.\n"综上,Agent Laboratory 把「文献—实验—写作—共享」串成了一条可编排的流水线,通过多智能体协作提升算力利用率与流程效率;人类仍保有监督与纠偏权,而系统则承担大量重复性工作,从而提升整体迭代速度。
要点速览
是什么: 许多智能体仍受限于预训练知识或人工整理出的知识边界,面对开放式问题时,往往只能停留在「复述已知答案」的层面。面对复杂世界,静态操作手册很难支撑真正的创新。关键跃迁在于,从「在已知目标函数上微调」转向「主动扩展状态空间」,主动去寻找未知的未知。
为什么: 在工程实践中,这通常会落地为面向探索任务的多智能体体系:不同模型分别承担提出假设、交叉评审、筛选与演化等职能,整体对齐科学方法的闭环。只有这样,系统才能在庞大的文献与实验空间中实现智能导航,把人力从重复试错中解放出来,加速从问题提出到洞见形成的转化过程。
经验法则: 只要问题域开放、演化快,且解空间尚未被形式化,就应启用探索与发现模式。科研、市场洞察、创意生产等需要持续提出新假设或新策略的场景最为典型;如果 KPI 是「找到从未想过的风险或机会」,而不是把旧流程再抠出 1% 效率,这个模式几乎不可或缺。
图示摘要:
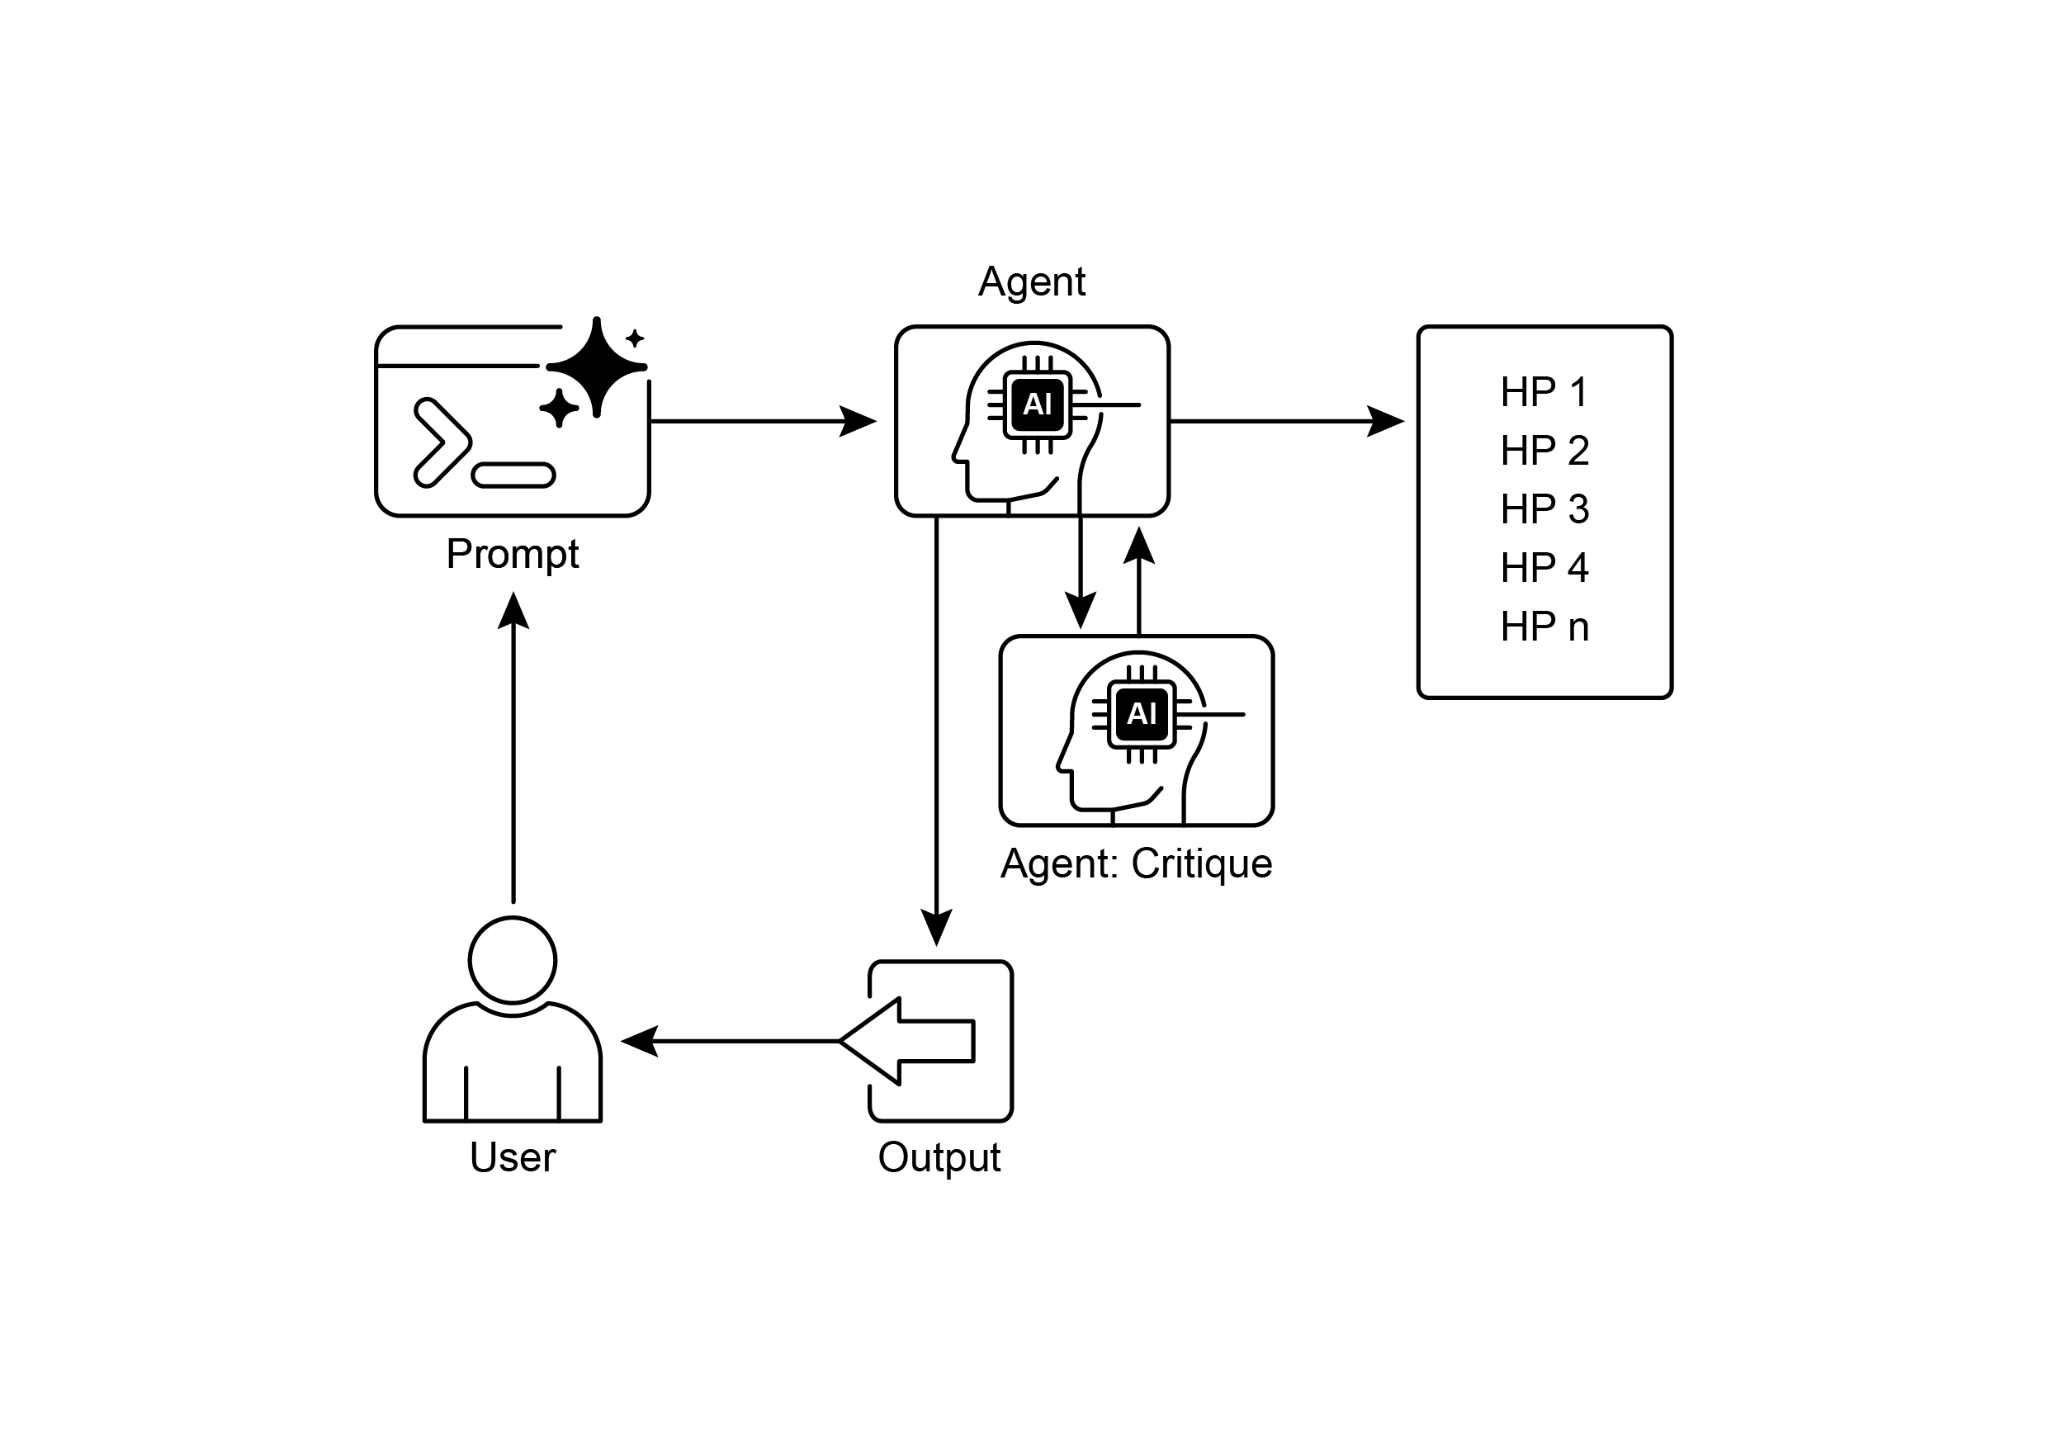
图 2:探索与发现设计模式(示意)
关键要点
- 探索与发现能力使智能体能够主动扩展信息边界,是应对复杂演化系统的重要保障。
- Google Co-Scientist 证明,多智能体系统可以自治完成「假设提出—互评—实验设计」的链条,成为人类研究团队中的数字化协作成员。
- Agent Laboratory 通过分角色流水线自动串联综述、实验与写作,展示了工程化科研助手的可行形态。
- 将算力密集的搜索与验证任务交给智能体处理后,人类便能把注意力集中在问题定义与价值判断上,整体创新节奏也会随之加快。
结论
归根结底,探索与发现刻画了「智能体之所以成为智能体」的关键特征:它不仅执行指令,还会主动拆分子目标、持续搜索潜在线索。面对复杂课题,单一模型往往难以胜任;通常需要多个智能体各司其职、相互博弈,才能逐步逼近真实科研团队的创造力与探索深度。Google Co-Scientist 就是典型例证。
Agent Laboratory 则进一步用「导师—执行—评审」式层级把流程产品化,让发现链路可以半自治运转。关键在于,它能够编排多智能体的涌现行为,使系统即便在弱监督下,仍能追逐长期、开放的目标。人机关系也因此升级:AI 不再只是被动工具,而是能自己开题、试错、汇总的合作者。当然,能力越强,安全与伦理护栏就越要同步加厚;只有把探索关在可控边界内,算力才能真正转化为可靠的新知生产引擎。
参考资料
- 探索—利用困境:强化学习与不确定性决策中的一个基本问题。https://en.wikipedia.org/wiki/Exploration%E2%80%93exploitation_dilemma
- Google Co-Scientist:https://research.google/blog/accelerating-scientific-breakthroughs-with-an-ai-co-scientist/
- Agent Laboratory:使用 LLM 智能体作为研究助手。https://github.com/SamuelSchmidgall/AgentLaboratory
- AgentRxiv:迈向协作式自主研究。https://agentrxiv.github.io/